藏文信息技术开源生态报告第二章 生态格局与资源基础
藏文信息技术开源生态报告第二章 生态格局与资源基础
藏文信息技术开源生态报告第二章 生态格局与资源基础
藏文技术生态已形成跨机构的数据与产品供给网络,典籍积累、语言工具、模型研发和机构应用相互衔接。 佛教数字资源中心(Buddhist Digital Resource Center,BDRC)提供馆藏、扫描和资源规格,Esukhia及其发展出的OpenPecha团队连接语言人才、文本加工与工具建设,Monlam藏文信息技术研究中心(Monlam Tibetan IT Research Centre,Monlam ITRC)将字体、词典和语言技术转为用户产品。资源持有、技术开发、受款与项目实施由不同主体承担,机构登记、任职经历、公开代码和资助协议共同呈现具体分工与合作关系。[1][2][3]
藏文信息技术开源生态报告第二章 生态格局与资源基础
藏文信息技术开源生态报告第二章 生态格局与资源基础
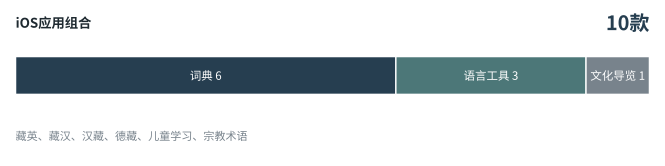
个人工具与机构馆藏形成两类稳定的使用场景。截至2026年10月23日,Apple美国区列有Lobsang Monlam名下10款应用,包含6款词典、3款语言工具和1款文化导览;Monlam公共门户在2025年第四季度处理逾130万次请求,服务逾2.5万名用户。数字图书馆首年在20家宗教与文化机构开展培训,为2,000个书架及70,000部母本集成二维码;2026年第三届联盟会议有来自49家项目参与机构的54名代表参会。查词、输入、问答、编目和馆藏管理使资源持续进入个人与组织的日常工作。[1][2][3][4]
美国政府资助按项目汇聚,并在执行期分次追加。截至2026年10月23日,社会与资源发展基金(Social and Resource Development Fund,SARD)、Wadhwani人工智能基金会及西藏基金会承接的三项合作协议,累计联邦支付义务合计11,715,600美元,其中西藏基金会协议占74.06%。已列交易中的新增义务分别集中在2023年的2,439,514美元、2024年的6,578,000美元和2026年的2,698,086美元;西藏基金会主协议项下两笔Monlam慈善信托次级资助报送合计377,916美元。资金由主协议连接受款机构,再进入具体执行项目和技术任务。[5][6][7][8][9][10]
藏文信息技术开源生态报告第二章 生态格局与资源基础
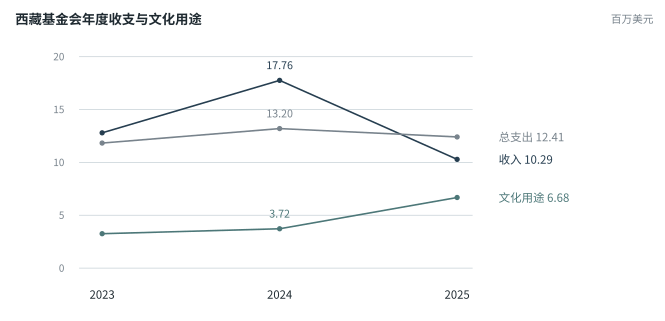
机构年度收支呈现出收入波动与文化用途支出增长并行的变化。西藏基金会的收入、收益及支持总额由2023年的12,794,979美元增至2024年的17,756,642美元,2025年降至10,286,233美元;文化和宗教保护/文化遗产保护支出则由3,255,698美元、3,722,492美元升至6,679,975美元。2024年收入增量主要来自捐款,2025年收入降额主要来自联邦赠款回落;按项目流向观察的累计义务与按年度观察的机构收支,共同呈现建设资金和持续运营投入的接续。[1][2][3][4]
现金、专业工时与数据支持共同承担研发和维护成本。pybo的建设投入包括22,000美元启动资助、BDRC两名专业人员六个月的数据整理与训练材料支持;数字图书馆在资金短缺期间,曾由私人资助者Alessia Bulgari承担项目员工一年的工资。基金会合作、私人支持、经营收入与专业人员投入分别支撑资料加工、软件开发和日常服务,具体项目的持续交付取决于这些投入能否接续。[5][6]
2.1 技术演进
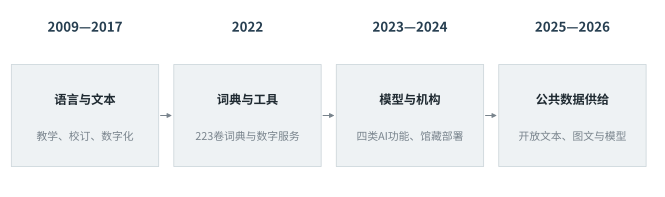
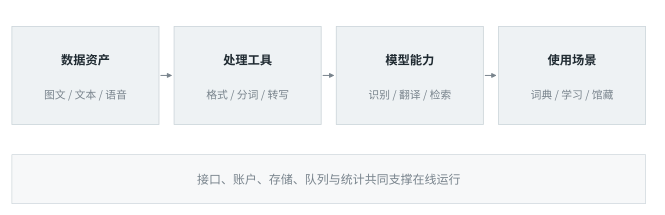
典籍加工提供了语言人员、标准化文本和工具,模型研发将这些积累转为翻译与识别,机构部署再把产品纳入馆藏和培训。沿“人才与文本—工具与模型—产品与机构”的关系,可以看到能力扩展的具体来源。
藏文信息技术开源生态报告第二章 生态格局与资源基础
2.1.1 语言与文本积累
Esukhia 从教师培训和译者协作积累语言人员。 Esukhia 是开展藏语教育、翻译协作和数字资源建设的非营利组织。其机构沿革记载,2009 年开展 Bridge 译者与藏文教师结对项目,2011—2012 年开展在线藏语教学,并参照欧洲语言共同参考框架(Common European Framework of Reference for Languages,CEFR)探索能力分级;2013—2014 年培训约 60 名教师,2015—2017 年团队规模约为 60 人。[1]
藏文信息技术开源生态报告第二章 生态格局与资源基础
Monlam 从字体和词典业务扩展至人工智能。 Monlam 藏文信息技术研究中心(Monlam Tibetan IT Research Centre,Monlam ITRC)由格西洛桑门朗(Geshe Lobsang Monlam)创办,机构自述成立于 2012 年,业务由字体、词典扩展至人工智能;MonlamAI 是其人工智能品牌及相关公开发布标识。[1][2][3]
藏文信息技术开源生态报告第二章 生态格局与资源基础
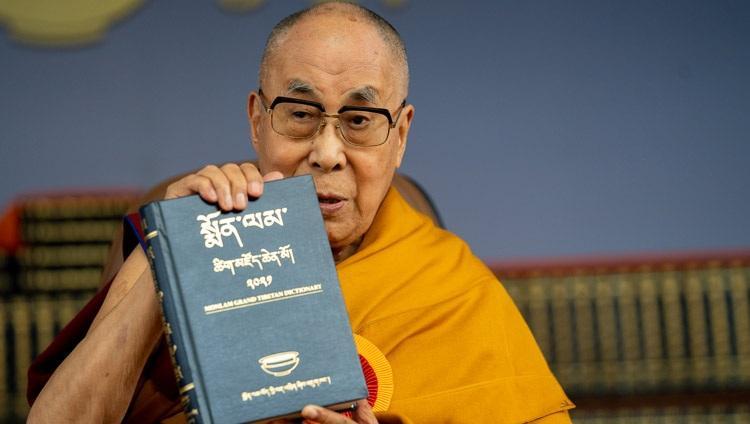
大词典将集中编纂成果扩展为多种数字服务。 2022 年 5 月 27 日,Monlam 藏文大词典在达兰萨拉发布。达赖喇嘛办公室的发布记录载明,该项目获达赖喇嘛信托(Dalai Lama Trust)支持,由 200 余人历时九年编纂,共 223 卷,并衍生 37 个应用和持续更新的网站。词条数量在该办公室原页中记为 20 万以上,在藏人行政中央同日发布记录中记为 39.5 万以上。[1][2]
藏文信息技术开源生态报告第二章 生态格局与资源基础
藏文信息技术开源生态报告第二章 生态格局与资源基础
数字图书馆将相关技术接入机构工作流程。 藏人行政中央(Central Tibetan Administration,CTA)是设于达兰萨拉的流亡政治与行政机构,其宗教与文化部负责项目中的机构协调,人工智能机构 Wadhwani AI 与 Monlam ITRC 参与技术实施。2024 年项目首年公告记载,在 20 家宗教与文化机构开展培训,为 2,000 个书架和 70,000 部母本完成二维码集成。2026 年 3 月第三届联盟会议报道记载49家项目参与机构的54名代表参会。[1][2][3]
藏文图书馆管理系统(Tibetan Library Management System,TLMS)把目录、扫描、二维码和馆藏业务连接起来。2025 年 6 月,CTA 宗教与文化部与 Monlam ITRC 共同组织目录分类专家会议,审议由 Monlam 提出的框架。[4][5]
Melong.ai 在识别与翻译之外增加问答和推理功能。 2025 年 11 月 Monlam Manifestation 发布活动报道介绍了 Melong.ai 问答平台及其 Monlam Think 推理功能、Monlam Bodyig-4 字体和大词典应用。报道转述的机构内测结果包括约 1,500 道题的 73% 正确率、印度中央中等教育委员会(Central Board of Secondary Education,CBSE)12 年级藏文考试的 71% 得分;发布方同时介绍了约 13 万词元上下文和 140 种语言支持。[6]
藏文信息技术开源生态报告第二章 生态格局与资源基础
多年期项目为跨机构建设提供组织和资金框架。 美国国际开发署(United States Agency for International Development,USAID)资助的“增强藏人社区文化韧性”(Strengthening Cultural Resilience of Tibetan Communities)项目于 2023 年启动,为期三年,数字图书馆是其重要内容。西藏基金会 2024 年审计报告另列“南亚藏人社区自立与韧性计划”(Program for Self-Reliance and Resilience of Tibetan Communities in South Asia),协议编号 72038624CA00006,期限为 2024 年 10 月至 2029 年 9 月,协议金额 3,000 万美元。该协议于 2025 年 1 月 28 日暂停,同年 7 月 1 日获准恢复。[1][2][3]
藏文信息技术开源生态报告第二章 生态格局与资源基础
2.1.5 开放训练资源
公开资产已覆盖词典、图像转写和大规模文本三个层次。 2022 年发布的 Monlam 大词典为 223 卷,并衍生 37 个应用。截至2026年10月23日,MonlamAI 数据集 OCR-Dergetenjur 列有 845,118 条图像与转写记录;OpenPecha 发布的 BoCorpus 数据卡列有 8 类合集、1,039 条记录、603,325,999 个字符,约为 6.03 亿字符。[1][2][3][4]
后续计划继续扩大机器可读文本的生产规模。 BDRC 于 2026 年 2 月 28 日公告,获钦哲基金会支持的开放佛教数据集计划已于 2025 年 12 月启动,由技术负责人 Élie Roux 主持,资助安排延续至 2027 年夏。项目目标是将数百万页文献转为机器可读格式,形成数万份标准化电子文本,并面向人工智能开发者发布。[6][7]
典籍加工形成的专业知识,经格式和工具固化后进入模型与馆藏服务。扩展所依靠的核心资源因此包含文本、数据和跨机构人才,组织关系需要同时沿这三类要素观察。
2.2 组织与人才
资源、研发、受款与实施职责分属不同主体,跨机构人才将这些职能接到同一项目。馆藏方提供材料和规格,语言专家完成整理,开发者维护工具及接口,高校研究人员开发模型,资助与行政机构支持项目落地。
藏文信息技术开源生态报告第二章 生态格局与资源基础
藏文信息技术开源生态报告第二章 生态格局与资源基础
Dharmaduta把文本加工与软件开发组织到产品线。 Dharmaduta 对外展示 WeBuddhist、Sherab、Pecha AI Studio、Pecha Data & API 四条产品线,分别涉及佛典阅读与社区、在线教育、人工智能工具和数据接口。其团队介绍及数据集署名显示,文本整理和软件开发共同参与产品交付。公司页面提出将服务利润的 70% 回投社区、30% 用于持续经营。[1][2][3][4][5]
藏文信息技术开源生态报告第二章 生态格局与资源基础
BDRC的2024年25周年机构说明记载,自1999年以来累计保存超过3,000万页佛教文献。[1]
BDRC/ALL-BDRC-alignments 数据卡记载 79,572 页对齐结果:亚洲传承图书馆(Asian Legacy Library,ALL)提供亚洲经典输入计划(Asian Classics Input Project,ACIP)的转写资源,结合 BDRC 等来源的扫描图像,由 Dharmaduta 完成对齐,并获钦哲基金会(Khyentse Foundation)支持。[2]
84000 与典籍项目提供内容和校订协作。 84000(Translating the Words of the Buddha)是佛典翻译与公开出版项目,其机构沿革记载,项目由钦哲基金会孵化,2013 年成为独立慈善组织。其与 Esukhia 的合作涉及《康珠尔》《丹珠尔》等典籍数字化,与高校的合作涉及译者培养、翻译研究和编辑工作。Barom/Esukhia 典籍项目在 pybo 藏文批处理工具的说明中被列为训练数据整理支持方。[3][4]
语言数据与科研能力互补。 Monlam 官网记载,Sebastian Nehrdich 在 Kurt Keutzer 指导下,于加州大学伯克利分校人工智能研究实验室(Berkeley Artificial Intelligence Research,BAIR)开展机器翻译研发,Monlam 提供数据。Dharmamitra 则是开展跨语种佛典语言技术研究的合作项目,其官网列出的合作方包括佛学研究与翻译支持机构 Tsadra Foundation、日本东北大学综合日本学研究中心(Center for Integrated Japanese Studies,CIJS)及伯克利 BAIR。[5][6][7]
该团队的 MITRA 研究论文报告,梵—藏、汉—藏、梵—汉三个语言对共形成 1,742,786 组自动挖掘的平行句对,并开发机器翻译模型 MITRA-MT 和语义嵌入模型 MITRA-E。[8]
藏文信息技术开源生态报告第二章 生态格局与资源基础
2.2.3 核心人才流动
人才联系沿三条具体路径展开:教学与校订人员进入数字化和模型协作,高校研究人员连接互文检索与机器翻译,开发者跨项目承担词典、数据接口和终端应用工作。Nehrdich从BuddhaNexus开发转入MITRA领导及东北大学任职,TenzDelek从MonlamAI进入Webuddhist-tech;BDRC的负责人接续又把学术研究、馆藏数据和项目治理联系起来。[1][2][3][4][5]
表2-1 核心人才的机构经历、项目角色与成果联系
| 人员 | 早期机构与专业经历 | 后续重要角色 | 连接的平台、数据或工具及作用 |
|---|---|---|---|
| Ngawang Trinley | Sherabling图书馆及教学;2009年共同创办Esukhia;84000德格《康珠尔》数字版校订 | Esukhia印度分支负责人、董事;BDRC数字化项目经理;Monlam AI/Mitra协作者 | 把扫描、校订、拼写和协作翻译经验用于文本加工、译者培养和模型材料准备[6][1] |
| Sebastian Nehrdich | 汉堡大学语言与佛学训练;2018年起开发BuddhaNexus;伯克利BAIR合作 | 2023年起参与MITRA,先任CTO、后任主任;2025年10月1日加入东北大学CIJS,11月加入BDRC董事会 | 将互文数据库、跨语检索、平行句挖掘和OCR用于Dharmamitra;2026年MITRA-lexicon形成六方向词典资源[7][2][8][5] |
藏文信息技术开源生态报告第二章 生态格局与资源基础
表2-1 核心人才的机构经历、项目角色与成果联系(续)
| 人员 | 早期机构与专业经历 | 后续重要角色 | 连接的平台、数据或工具及作用 |
|---|---|---|---|
| Kurt Keutzer | 伯克利BAIR的人工智能研究与机器翻译指导 | Dharmamitra共同创办人、战略顾问;MITRA论文作者 | 提供算法、模型训练与研究组织支持,连接高校研究和佛典翻译应用[1][2][3][4] |
| Élie Roux | 自2017年在BDRC设计软件与数据架构 | 2021年钦哲愿景项目顾问;2026年开放数据计划负责人;Pecha API工作组BDRC成员 | 连接馆藏元数据、关联开放数据、文本编码、自动音译和语言工具,推动文献转为机器可读资源[5][6] |
| Jann Ronis | 2006年在TBRC参与书目提纲;后在伯克利任教 | 2018年接任BDRC执行主任 | 早期目录工作进入馆藏元数据模板,任内推进BUDA及跨机构数字档案访问[7] |
藏文信息技术开源生态报告第二章 生态格局与资源基础
表2-1 核心人才的机构经历、项目角色与成果联系(续)
| 人员 | 早期机构与专业经历 | 后续重要角色 | 连接的平台、数据或工具及作用 |
|---|---|---|---|
| Gregory Forgues | 维也纳大学博士、莱顿大学Open Philology研究;84000等机构的领导或治理工作 | 2026年5月获任BDRC执行主任;Dharmamitra顾问 | 将语文学、翻译机构和数字研究经验接入资源机构治理及人工智能工具合作[1][2] |
| Gedun Rabsal | 瓦拉纳西藏学研究;2002年起在印第安纳大学教授藏语文学 | 2026年6月当选BDRC董事会主席 | 把文学史、翻译与编辑经验用于馆藏机构的学术方向和合作网络[3] |
| TenzDelek | 公开履历列此前任职MonlamAI;2024年提出大词典编辑器设计 | Webuddhist-tech软件工程师(SDE 2) | 连接Monlam词条编辑、查询与用户角色设计,以及后续平台开发[4] |
| Ju Tenkyon | Monlam大词典框架主编 | BoBench文学领域专家 | 将词典与文学知识用于题目、参考答案及专业评价内容[5][6] |
| Tenzin Rabten | Dharmaduta佛教数据专业岗位与联合创始团队 | ALL-BDRC图文对齐项目的手稿识别贡献者 | 把文本知识用于扫描图像识别和对齐,参与79,572页图文资源生产[7][8][9] |
藏文信息技术开源生态报告第二章 生态格局与资源基础
2.2.3.1 Ngawang Trinley:文本与模型
寺院图书馆和教学经历形成文本组织基础。 Ngawang Trinley在印度学习藏语及相关学科后,负责Sherabling的College of Buddhist Sciences图书馆,并承担藏语和相关课程教学。2009年共同创办Esukhia后,继续担任印度分支负责人和董事,工作涉及语言教学、翻译、转写与项目组织。[1]
84000与BDRC把校订经验接入馆藏资源。 他参与84000所用德格《康珠尔》数字版的校对和编辑,后在BDRC担任数字化项目经理,负责扫描件与电子文本以及用户、合作机构关系。其开发和组织的工具包括实时在线协作翻译、校对软件及藏文拼写检查,分别服务译者协作、文本修订和语言规范化。[2][1]
译者课程与模型合作继续使用同一套专业经验。 RYI讲者资料介绍,Kumarajiva Project将其沉浸式藏语课程用于译者培养;相关报告还介绍他参与Monlam AI/Mitra机器翻译和佛教大语言模型工作。[1]
藏文信息技术开源生态报告第二章 生态格局与资源基础
数据成果把人员联系转为可使用的资源。 MITRA研究形成1,742,786组多语平行句对,用于翻译和语义模型;2026年10月发布的MITRA-lexicon进一步组织梵英、梵藏和梵汉六方向词典,合计218万词头条目及1,040万条引用例证,每条例证连接平行句对和字符位置。2025年11月Nehrdich加入BDRC董事会,馆藏资源与模型研究又增加了治理层的联系。[1][2][3][4]
2.2.3.3 Élie Roux:馆藏与数据
BDRC的技术岗位连接数字馆藏与外部合作。 Roux自2017年起在BDRC设计软件和数据架构,并管理与学术机构、传统文献机构和馆藏的合作。其专业工作涉及关联开放数据、文本表示和藏文自然语言处理,已有藏文拼写检查、动词检查及文本编码工具。[5]
藏文信息技术开源生态报告第二章 生态格局与资源基础
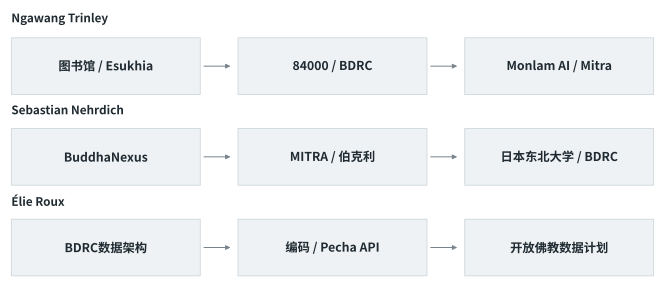
2.2.3.4 BDRC治理接续
创办人和早期目录人员奠定馆藏组织方法。 E. Gene Smith(1936—2010)于1999年创办TBRC。Jann Ronis于2006年以驻馆研究人员身份与Smith合作,参与早期书目提纲编制;该提纲后来成为BDRC元数据的重要模板。Ronis随后在伯克利东亚语言与文化系任教,2018年7月15日转任BDRC执行主任,接替在该机构服务17年的Jeff Wallman。[4][5]
数字档案平台成为学术与馆藏之间的共同入口。 Ronis任内推出Buddhist Digital Archives(BUDA),扩展检索与合作机构资料连接。BDRC沿革记载,BUDA于2021年上线,采用关联开放数据组织馆藏,使扫描件、目录和相关文献可通过同一平台检索。[5]
藏文信息技术开源生态报告第二章 生态格局与资源基础
2026年的治理调整引入翻译、语文学和文学史经验。 5月18日获任执行主任的Gregory Forgues拥有维也纳大学博士和莱顿大学Open Philology项目研究经历,并曾在84000、钦哲基金会、Siddhartha’s Intent及Tsadra Foundation承担领导或治理工作;Dharmamitra也将其列为顾问。6月25日当选董事会主席的Gedun Rabsal曾在隆务寺、甘丹绛孜学院及瓦拉纳西藏学机构学习研究,2002年起在印第安纳大学伯明顿分校教授藏语文学,并从事文学史、翻译和期刊编辑。[1][2][3]
2.2.3.5 Dharmaduta创始团队
文本专业组负责把文献知识转为数据内容。 官网将Tenzin Rabten、Tsering和Gade列为三名佛教数据专业联合创始人。ALL-BDRC-alignments的署名将Tenzin Rabten列入手稿识别人员,将Gade列入逐页对齐人员;该项目以ACIP转写和馆藏扫描形成79,572页图文对齐资源,由Dharmaduta加工、BDRC提供规格、钦哲基金会支持。[4][5]
藏文信息技术开源生态报告第二章 生态格局与资源基础
执行团队继续按产品配置开发者和文本人员。 2026年10月23日团队页面列43条人员记录:运营5条、WeBuddhist17条、Sherab2条、Pecha AI Studio8条、Pecha Data & API11条。WeBuddhist组含6个软件开发岗位和11个文本专业岗位,文本知识与软件实现被放入同一工作组。[1]
2.2.3.6 开发者与产品关联
TenzDelek的任职变化伴随词典产品开发。 其公开履历列此前任职MonlamAI,现为Webuddhist-tech软件工程师SDE 2。2024年12月17日,他在OpenPecha项目中提出Monlam大词典编辑器设计,任务包括词条修改、查询和用户角色管理;kaldan007参与该议题的评阅。[2]
Pecha API工作组把多个机构与产品的人员放在同一接口任务中。 Tashi Tsering的GitHub资料列Esukhia,其账号ta4tsering与工作组开发岗位对应,工作组主席栏也列其姓名;Tenzin Kunsang的账号tenkus47列Webuddhist、Dharmaduta、OpenPecha和Monlam,工作组中对应Pecha AI Studio。成员表另列Gabor Detari为负责人、Tenzin Tsering为开发者、Élie Roux代表BDRC、Tenzin Samten对应WeBuddhist、Tenzin Tsewang对应Pecha Data,项目共同连接Pecha API、Toolkit V2与STAM。[3][4]
藏文信息技术开源生态报告第二章 生态格局与资源基础
教学活动为开发和标注培养人员。 2025年1月31日Sarah College活动共有21名参与者,课程涉及人工智能、文本与图像标注;2月2日DLIHE活动有28人,包括17名学生、3名教师和8名Monlam讲师及组织者,课程包括代码可读性、版本控制及真实项目协作。DLIHE同年2月院刊记载了该项软件工程实训。青年项目还提供奖学金、职业认证、导师和实习安排。[1][2][3][4][5]
财务岗位也在公益机构之间流动。 Manjushri Educational Services的职业简介记载,Tenzin Lhazey于2025年4月加入,担任办公室行政与会计;此前在Monlam Charitable Trust与Bir Tibetan Society合计约五年的经历覆盖记账、审计、财务规划、收支分析,以及商品与服务税(GST)和源头扣税(TDS)申报。[6]
藏文信息技术开源生态报告第二章 生态格局与资源基础
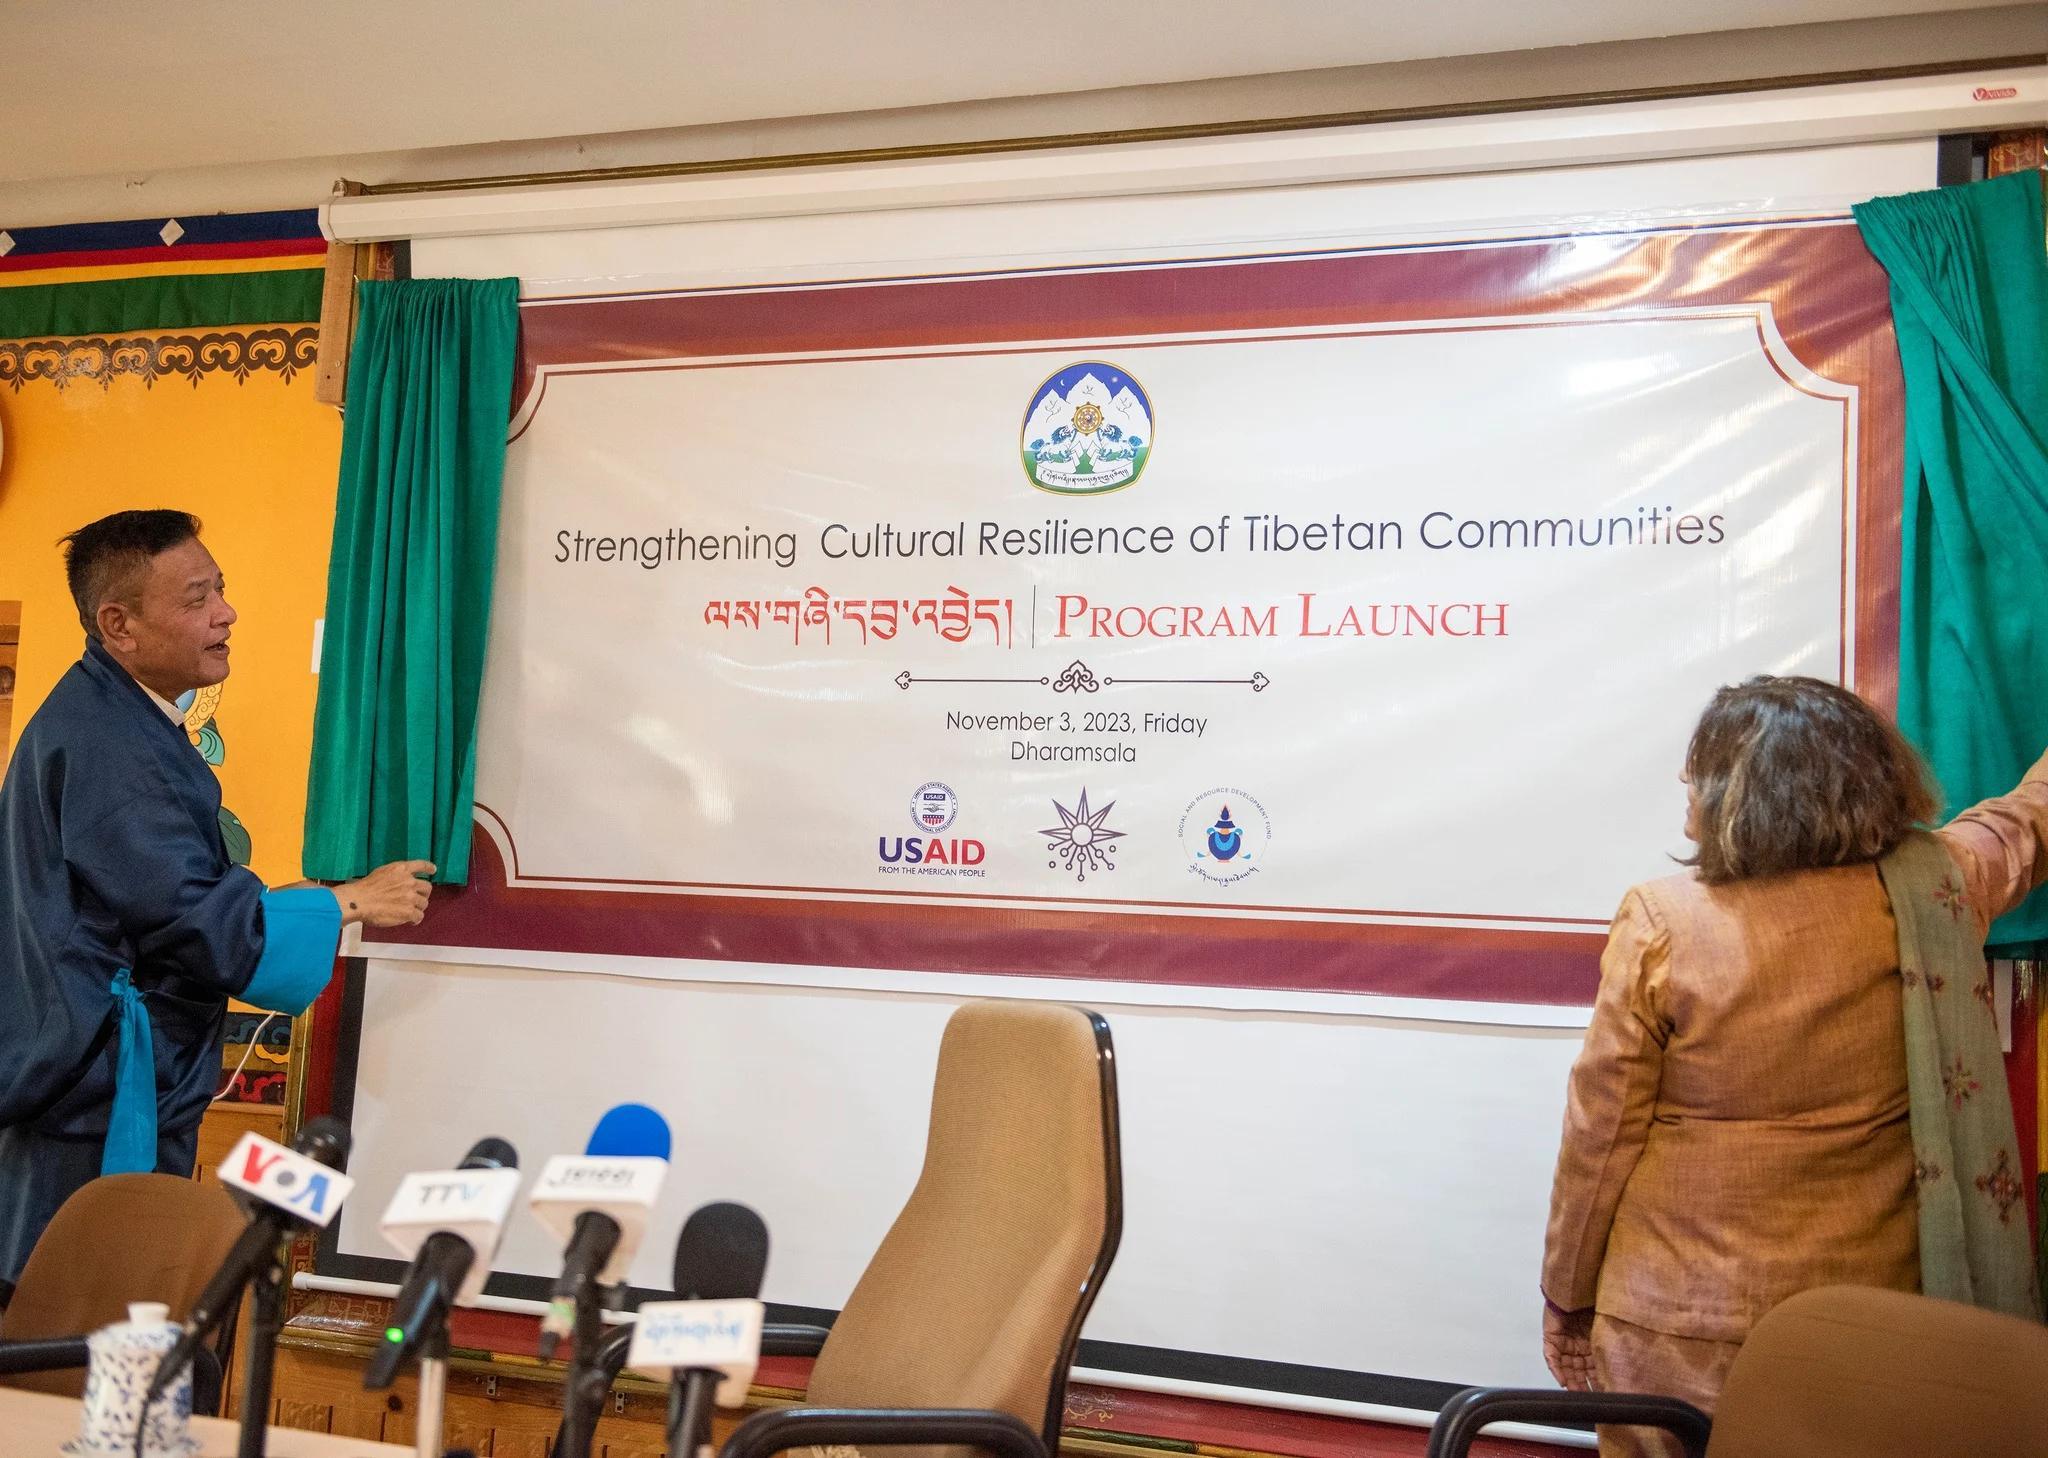
Wadhwani AI以人工智能研发和平台实施承接文献数字化项目。 机构由Romesh Wadhwani与Sunil Wadhwani创办,2018年启动;2026年10月官网列Shekar Sivasubramanian为机构负责人,Alpan Raval为人工智能与机器学习首席科学家。数字图书馆项目由Wadhwani AI承担主要技术工作,与Monlam ITRC协作开发数字资源库;2023年合作协议的受款方为Wadhwani Institute for Artificial Intelligence Foundation。[2][1][3]
SARD 承担发展援助和项目协调。 社会与资源发展基金(Social and Resource Development Fund,SARD)官网记载,该组织由 CTA 于 1997 年建立,参与发展援助及项目组织,公布的外国捐款许可编号为 182450041;截至2026年10月23日,该机构人员页面列 Lobsang Tenzin 为主任。[4]
藏文信息技术开源生态报告第二章 生态格局与资源基础
西藏基金会与钦哲基金会将资金投入不同建设环节。 西藏基金会(The Tibet Fund)是美国非营利机构,EIN 为 13-3115145。其年报记录对 Monlam 语言资源、人工智能及发布活动的支持,审计和税务资料列示项目资助与拨付安排。钦哲基金会 EIN 为 91-2167303,其支持涉及 pybo、84000 和 BDRC 开放数据计划。[1][2][3][4][5]
藏文信息技术开源生态报告第二章 生态格局与资源基础
西藏基金会的治理与项目管理支持资金转拨。 2023年度Form 990列Robert Ankerson为主要负责人,治理机构有11名有表决权且独立的成员、5名员工和约11名志愿者;相关赠款经管理层审查、董事会预算批准及书面协议进入项目执行。[1][2]
2.2.5 代码与发布权限
两个Monlam产品保留了OpenPecha的代码来源联系。 MonlamAI的monlamai-app-web及MonlamGrandDictionaryEditor项目说明含OpenPecha标识或代码克隆路径。[3][4][5]
跨机构协作通过具体岗位、接口和资助任务落实:同一人员能把馆藏经验带入模型,同一工具能服务多个产品,同一项目能汇聚多方投入。平台和产品的实际能力,取决于这些联系最终形成的资源及可持续服务。
2.3 数据与产品
技术链由数据、加工规则、模型、后台和应用组成,表2-2归并35项技术与运营对象。公开数据的价值通过训练采用体现,工具能力通过接口和用户产品体现,个人应用与机构馆藏又形成不同的运行场景。
藏文信息技术开源生态报告第二章 生态格局与资源基础
藏文信息技术开源生态报告第二章 生态格局与资源基础
表2-2 技术链分工:八类职能覆盖35项技术与运营对象(续)
| 层次 | 主要对象 | 主要作用 |
|---|---|---|
| 结构化与加工规则(7项) | OPF;Toolkit/编辑器 | 组织文本版本、标注和数据交换[1] |
| 结构化与加工规则(续) | Botok;pybo;pyewts/dakje | 分词、批处理、转写与书写辅助[2] |
| 结构化与加工规则(续) | Pydurma/校勘工具;自然语言处理(Natural Language Processing,NLP)及对齐工具群 | 校勘、异文处理与文本对齐[3] |
| 词典与字形(3项) | Monlam大词典;词典编辑器;字体资产 | 提供释义、编辑和字符显示资源[4][5][6] |
| 模型、评测与智能交互(5项) | Monlam Melong;Bo-Eval | 提供问答、推理及知识与语音评测[7][8][9] |
藏文信息技术开源生态报告第二章 生态格局与资源基础
表2-2 技术链分工:八类职能覆盖35项技术与运营对象(续)
| 层次 | 主要对象 | 主要作用 |
|---|---|---|
| 模型、评测与智能交互(续) | Hugging Face(模型与数据托管平台)的OpenPecha发布账号;Buddhist Consensus/Webuddhist AI;Assistant-Agent助手后端 | 公开模型与数据,组织检索问答及助手服务[1][2][3] |
| 接口与后台(5项) | Monlam AI API;OpenPecha API/PechaAPI;Pecha Data & API文本接口产品线 | 连接账户、模型与文本资料[4][5][6] |
| 接口与后台(续) | WeBuddhist后端与任务程序;Matomo Tracker | 处理内容任务与访问分析[7][8] |
| 用户与机构应用(6项) | Monlam AI Tools Web;Monlam Keyboard;WeBuddhist Web/App | 面向个人提供语言工具、输入与阅读[4][9][10][11] |
藏文信息技术开源生态报告第二章 生态格局与资源基础
表2-2 技术链分工:八类职能覆盖35项技术与运营对象(续)
藏文信息技术开源生态报告第二章 生态格局与资源基础
表2-3 主要数据资产的类型、规模与训练及公开供给作用
| 资源类型与资产 | 规模及期间 | 公开供给形式 | 已记录的训练采用或评测作用 |
|---|---|---|---|
| 图像转写:OCR-Dergetenjur | 2026年10月23日平台列845,118条图像与转写记录 | MonlamAI数据集页面提供记录与数据文件 | 德格《丹珠尔》图像与转写形成文字识别及文本处理材料[1] |
| 图文对齐:ALL-BDRC-alignments | 79,572页对齐结果 | 数据卡列扫描、转写、加工方和公开资源入口 | Yigdzin 1训练说明将其列为图文输入资源[2][3] |
| 文本合集:BoCorpus | 8类合集、1,039条记录、603,325,999字符,约6.03亿字符 | 按BDRC规格形成标准化文本合集,由Dharmaduta加工并公开发布 | Yigdzin 1使用其文本生成合成页面,将纯文本转为OCR训练输入[4][3] |
| 语音及转写:stt-training-data | 2024年10月18日采集概览:1,391,020个文件、1,576.76小时、8类场景;公开分集:训练1,362,015条、验证20,742条,合计1,382,757条 | 公开音频、转写、类别与时长等字段,按训练和验证划分发布 | 为语音识别开发提供可获取的音频—文本材料及验证划分[5] |
| 多语平行语料:MITRA | 梵—藏、汉—藏及梵—汉合计1,742,786组自动挖掘句对 | 论文、代码和数据入口共同提供语言对及加工方法 | 形成MITRA-MT机器翻译模型和MITRA-E语义嵌入模型,服务跨语种翻译与检索[6] |
| 分词训练文本:ACTib | 17,731,410行文本 | 同一底层语料提供未分词与定制Botok分词版本 | 用于字符五元KenLM训练和规范化候选重排序,分词工具经数据加工进入下游模型[7] |
藏文信息技术开源生态报告第二章 生态格局与资源基础
藏文信息技术开源生态报告第二章 生态格局与资源基础
代码与数据平台为分散生产和公开分发提供组织条件。 2026 年 10 月 23 日组织页面显示,MonlamAI 有 4,297 个公开仓库,Webuddhist-tech(原 OpenPecha 组织)有 555 个,Esukhia 有 115 个,合计 4,967 个。仓库中包含数据分片、加工脚本、模型服务和应用项目;Hugging Face 则集中提供模型文件、数据集和演示服务。[1][2]
2.3.2 图文与语音技术
图像识别将典籍页面转化为可计算文本。 光学字符识别(Optical Character Recognition,OCR)工具群覆盖图像预处理、版面切分、字符识别和转写输出,TibetanOCR_PyTorch、OCR-Pipelines等项目组织相关工序。[3]
书体分类为识别流程提供分流信息。 OpenPecha的uchen-ume-classifier配套数据卡列有10,961页BDRC扫描件,训练、验证和测试分别为9,110页、1,000页、851页,用于乌金体与乌梅体分类;tibetan-script-classifier设置18个识别标签,包含书体、混合书体和非藏文等辅助类别。[4][5]
版面标注把原图、掩码和部分文献来源连接起来。 数据集列有43,251条记录,其中6,260条填写了28个不同BDRC作品编号,并列原图和掩码链接,支持版面分析与来源对应。[6]
Yigdzin 1模型卡列明训练资源和识别测试结果。 BDRC 的 Yigdzin 1 藏文 OCR 模型约有 8 亿参数,基于 PaddleOCR-VL-1.6,数据说明列有 ALL-BDRC 图文对齐资源及 BoCorpus 合成页面。发布方在 1,070 页基准上的测试报告显示,逐页字符错误率的平均值为 6.28%,中位数为 1.42%。[7]
藏文信息技术开源生态报告第二章 生态格局与资源基础
语音识别与合成扩大了语言资源的输入和输出方式。 语音识别(Speech-to-Text,STT)将录音转为文本,语音合成(Text-to-Speech,TTS)将文本转为音频。stt-training-data提供音频与转写数据,pecha-tools-for-stt提供语音数据采集网页工具,Monlam AI 的发布公告与接口项目列有 STT、TTS 功能,WeBuddhist 后台任务程序则组织音频生成和队列任务。[1][2][3][4]
2.3.3 文本与语言工具
结构化格式将作品、版本和标注组织为可交换对象。 OpenPecha 格式(OpenPecha Format,OPF)按作品、数字版本、底本文本及标注层组织典籍;Toolkit 处理创建、编辑、转换和导出,OpenPecha-Editors 提供编辑入口,Pydurma 支持校勘与异文处理。[5][6][7]
第二代工具将文本处理与云端存储连接起来。 2025 年 10 月 29 日发布的 openpecha 2.5.0 采用独立式文本标注模型(Stand-off Text Annotation Model,STAM),将正文和标注分离,项目说明使用 Firebase 作为存储与访问后端,并提供序列化、导出等能力。[8]
藏文信息技术开源生态报告第二章 生态格局与资源基础
词典编辑器维护词条,字体集合与预览工具服务文字显示。 2022 年 Monlam 大词典发布记录列有 223 卷、200 余名参与者、九年建设及 37 个应用;词典编辑器连接账户、数据库和接口服务。Monlam 字体及 OpenPecha 字体集合支持网页、文档与移动端显示,Monlam Font Viewer 提供字体预览入口。[1][2][3]
分词与语言工具将处理规则嵌入下游数据流程。 Botok 处理词边界、词元、词性和规范化词形,pybo 提供排序与批处理,pyewts 支持 Unicode 与扩展 Wylie 转写转换,dakje 提供书写辅助;Esukhia 的 bophono、sympound-python 等项目分别处理音系转写和拼写建议。[4]
PaganTibet 的 ACTib 语言模型数据页面列有 17,731,410 行文本,项目说明介绍了采用定制 Botok 的处理版本,并将相关数据用于字符五元 KenLM 训练和文本规范化候选重排序。[5]
藏文信息技术开源生态报告第二章 生态格局与资源基础
生成式问答和检索增强服务扩大内容组织方式。 2025 年产品发布报道介绍 Melong.ai 问答平台及其 Monlam Think 推理功能,并转述约 13 万词元上下文、140 种语言和图文输入能力。buddhist-consensus 项目的当前说明以 Webuddhist AI 为名,采用检索增强生成(Retrieval-Augmented Generation,RAG),支持混合、关键词、语义和精确匹配四类检索,使用 Milvus 保存向量索引、LangGraph 组织处理流程,并接入 Gemini 生成服务。[1][2][3][4]
平行语料进一步形成可查询的跨语词典。 2026年10月19日发布的MITRA-lexicon研究由Nehrdich等提出,覆盖梵英、梵藏和梵汉六方向词典,合计218万词头条目及1,040万条引用例证;例证连接句对、词语及译词的字符位置,并提供网页查询入口。[5]
藏文信息技术开源生态报告第二章 生态格局与资源基础
2.3.5 接口与后台服务
Monlam 的网页和接口项目汇集多模态任务。 应用程序接口(Application Programming Interface,API)用于连接客户端与后台服务。monlamai-app-web 项目说明列出 Auth0 身份认证、PostgreSQL 数据库、AWS S3 对象存储及模型接口配置;monlamai-API 采用 FastAPI,组织翻译、OCR、聊天、用户和文件相关功能。[1][2]
数据接口与助手后端承担不同的服务任务。 OpenPecha-API提供文本数据接口,PechaAPI是另一个使用FastAPI的服务端仓库;Dharmaduta的Pecha Data & API为文本接口产品线。Assistant-Agent提供助手应用后台,pecha.tools的藏英译后编辑工具组合Dharma Mitra、ChatGPT和Bing Translate接口。[3][4][5][6]
内容平台通过专门后台组织音频和用户任务。 WeBuddhist 后端处理内容及业务接口;webuddhist-worker 当前说明通过 HTTP API 访问主后端内容和计划,使用独立 PostgreSQL 保存提醒与通知,使用Amazon简单队列服务(Simple Queue Service,SQS)排列音频及通知任务,Redis 提供幂等与缓存支持。[7]
Matomo封装支持页面、搜索、下载和外链事件统计。 Matomo Tracker 的 React 封装说明列有页面访问、事件、站内搜索、下载和外链统计,并提供用户标识、心跳及同意配置。[8]
藏文信息技术开源生态报告第二章 生态格局与资源基础
2.3.6 移动产品组合
同一卖方的10款应用覆盖三类主要用途。 截至2026年10月23日,Apple美国区应用商店列有Lobsang Monlam名下的6款词典、3款语言工具和1款文化导览应用。首次发布日期跨越2016—2026年,4款应用的版本更新日期集中于2026年10月。[1]
藏文信息技术开源生态报告第二章 生态格局与资源基础
表2-4 Lobsang Monlam名下10款移动应用(Apple美国区,截至2026年10月23日)
| 应用及分述 | 主要功能与资源 | 首次发布日期 | 版本/更新日期 |
|---|---|---|---|
| Monlam AI(第2.3.6.1节) | 面向学习、研究与创作的移动藏文语言服务 | 2026-10-20 | 1.0.0/2026-10-20[1] |
| Monlam Translate(第2.3.6.2节) | 藏英文本翻译、语音转文字及图像文字识别 | 2024-11-03 | 1.1.8/2026-10-19[2] |
| Monlam Keyboard(第2.3.6.3节) | 藏文输入、智能候选、自动纠错与实时修正 | 2024-10-25 | 0.3/2026-10-14[3] |
| Monlam Grand Dictionary(第2.3.6.4节) | 藏英查词、释义与音标信息、离线浏览和收藏 | 2025-11-03 | 2026.2.3/2026-10-20[4] |
| Tibetan-Chinese Dictionary(第2.3.6.5节) | 藏汉查询,超过50,000个检索条目,支持简繁体中文 | 2018-01-31 | 1.0/2018-01-31[5] |
| Chinese Tibetan Dictionary(第2.3.6.6节) | 汉藏查询,超过80,000个检索条目,支持简繁体与拼音 | 2016-09-05 | 2.1/2017-09-02[6] |
| Deutsch-Tibetisches Wörterbuch(第2.3.6.7节) | 超过15,000组德藏译对,连接印度技术团队与瑞士出版机构 | 2020-09-09 | 3.1/2025-01-16[7] |
藏文信息技术开源生态报告第二章 生态格局与资源基础
表2-4 Lobsang Monlam名下10款移动应用(Apple美国区,截至2026年10月23日)(续)
2.3.6.1 Monlam AI:多模态工具
移动端教育应用面向日常藏文使用。 Monlam AI由同名团队开发,商店将其列为教育应用,面向学习者、研究者、创作者及日常使用藏文的用户,并提供iPhone和iPad端入口。[4]
同名移动应用于2026年进入产品组合。 Apple美国区资料记载,该应用于2026年10月20日发布,版本为1.0.0,卖方为Lobsang Monlam。[4]
Android版将四类语言任务集成到同一应用。 Google Play介绍列有翻译、语音转文字、文字转语音和图像文字识别:用户可录音或上传音频生成可编辑转写,从文献页面、题记等图像提取藏文,再复制、分享或收听处理结果。应用支持藏英界面切换。[5]
机构与个人创作共用移动入口。 Android产品介绍进一步列出学生、研究者、译者、寺院和出版机构等用户。2026年10月24日,Google Play下载量显示为10+档位。图像转文字、转写和语音合成相结合,可帮助这些用户将纸本和口述材料整理为可分享的文字与音频。[5]
藏文信息技术开源生态报告第二章 生态格局与资源基础
2.3.6.2 Monlam Translate:藏英翻译
三类输入方式汇入藏英翻译。 Monlam Translate提供藏文与英文之间的文本翻译,同时支持语音转文字,以及从图像提取藏文的光学字符识别(OCR)。[1]
学习与交流构成主要使用场景。 商店介绍面向语言学习、文化阅读和日常沟通用户。该应用于2024年11月3日发布,1.1.8版本于2026年10月19日更新。[1]
Android版覆盖旅行、课堂和材料阅读。 Google Play列示的目标群体包括旅行者、学生、教育工作者和语言爱好者;使用示例包括拍摄路牌、菜单及文档,导入书页照片,以及进行藏英双语对话。2026年10月24日,该版本累计下载量处于10K+档位。拍照翻译可用于参访时理解文字说明、课堂中对照藏英表达;双语对话可辅助向英语使用者介绍藏文材料。[2]
2.3.6.3 Monlam Keyboard:输入辅助
语言辅助直接进入用户输入过程。 Monlam Keyboard提供藏文键入、智能文本建议、自动纠错和实时修正,适用于消息、文档及社交媒体文本输入。[3]
键盘扩展依托移动系统的输入机制。 Apple的自定义键盘开放访问由扩展配置请求,用户在系统设置中开启相应权限;安全文本输入使用系统键盘。该应用于2024年10月25日发布,0.3版本于2026年10月14日更新。[3][4]
词形与搭配预测有助于将藏文书写带入日常交流。 开发方进一步介绍了前后缀和词语搭配预测,针对藏文叠字逐字输入的操作提供辅助,场景包括短信、邮件及社交媒体表达。这种设计可减少藏文文本输入中的操作步骤,便于用户在手机上撰写文化讲解、活动通知和个人消息。[5]
2.3.6.4 Monlam Grand Dictionary:藏英查词
词条查询同时呈现释义与音标。 Monlam Grand Dictionary支持藏文检索、藏英词汇查询、词条浏览和收藏,商店简介列有释义与音标信息,并突出离线使用。[6]
藏文信息技术开源生态报告第二章 生态格局与资源基础
词库与个人查询记录主要保存在设备。 开发者政策将词典数据库、搜索历史、收藏及界面配置列为本地数据,并说明主动导出、配置同步、更新检查和语言包下载。该应用于2025年11月3日发布,2026.2.3版本于2026年10月20日更新。[1][2]
共同编纂的词典资源通过统一查询进入移动端。 开发方介绍,词典工程有37个以上编纂团队参与,2022年第三版印刷本为223卷;2025年软件第四版在藏文词典基础上汇入多部藏英、英藏词典,提供统一检索,便于读者并列查阅藏文释义与跨语种对应词。[3]
Android版以学习、翻译和研究为主要用途。 Google Play介绍明确列出学生、译者及研究者,并支持词语、短语和学术术语查询。2026年10月24日累计下载量显示为10K+。离线查询与词条收藏可支持课堂阅读、译稿处理和个人词汇积累。[4][1]
2.3.6.5 藏汉词典:五万余词条
藏汉词条支持藏文阅读与学习。 Tibetan-Chinese Dictionary提供藏文至中文的词汇查询。开发者介绍列有超过50,000个检索条目,支持简体和繁体中文,面向学者、学生及藏文学习者。[5]
内容机构与技术团队共同开发词典。 应用由Monlam藏文信息技术研究中心与International Tibetan Buddhism Study Institute合作推出,后者为商店资料列示的研究合作方。Apple美国区所列首次发布日期和1.0版本更新日期均为2018年1月31日。[5]
已有词典的藏汉对照内容成为移动查询资源。 官方介绍将1991年出版的汉藏词典、藏英汉常用词资源,以及五语对照词典中的藏汉内容列为资料来源。中文释义与简繁体显示可帮助中文读者对照藏文词汇,为双语教学、文献阅读和文化概念解释提供查词入口。[6][5]
2.3.6.6 汉藏词典:八万余词条
汉藏词条与拼音辅助汉语学习。 Chinese Tibetan Dictionary提供汉语至藏文的词汇查询,开发者介绍列有超过80,000个检索条目,支持简体、繁体中文及拼音。2.1版本说明还列有拼音修正和注音符号支持。[7]
藏文信息技术开源生态报告第二章 生态格局与资源基础
同一合作关系覆盖两个查询方向。 该应用同样由Monlam ITRC与International Tibetan Buddhism Study Institute合作推出,服务汉语学习者及双语研究、教学使用。该应用于2016年9月5日发布,2.1版本于2017年9月2日更新。[1]
汉语书写与读音辅助连接藏文释义。 官方介绍将1991年出版的汉藏词典等资源纳入内容来源,并同时提供简体、繁体、拼音和注音符号。用户可从熟悉的汉语字形与读音进入藏文对应表达;在双语课程和交流材料准备中,这种查询方式可辅助统一常用词的表达。[2]
2.3.6.7 德藏词典:语言学习
一万五千余组译对面向德语地区的日常交流。 Deutsch-Tibetisches Wörterbuch提供超过15,000组德语—藏语译对,词汇内容主要对应德语地区藏人社会的日常生活。[3]
出版机构与语言技术团队共同推出产品。 应用由Monlam ITRC(印度)与Tibet Institute Rikon(瑞士)联合开发,词表基于Losang Tenzin Mantö编写、Tibet Institute Rikon出版的德藏词典。该应用于2020年9月9日发布,3.1版本于2025年1月16日更新。[3]
三类学习者对应语言传承与跨语交流的不同需求。 Rikon的2020年报明确列出藏族年轻一代、新迁入德语地区的藏人,以及对藏语感兴趣的西方学习者。词条配有藏文发音转写,操作界面同时使用德语和藏语,可分别支持年轻用户学习母语、新迁入者学习德语,以及德语读者接触藏语词汇。[4]
免费移动和桌面版本延伸了词汇资源的使用场景。 产品覆盖iOS、Android、macOS和Windows四类系统。Rikon年报记录,截至2020年底,Apple与Google两家应用商店的全球安装量合计约3,000次;2026年10月24日,Google Play所列Android累计下载量为5K+档位。[4][5]
2.3.6.8 入门词典:儿童教育
缩略条目以分层方式组织学习内容。 Monlam Elementary Dict的商店介绍列出220项英语缩略条目、370项入门条目及约1,290项基础文本条目,并说明采用简明释义。产品内容围绕藏文材料与西方缩略表达的比较展开。[6]
藏文信息技术开源生态报告第二章 生态格局与资源基础
初学者和教师是其主要服务对象。 开发者将该应用定位为藏文入门学习及新教师的教学辅助工具。Apple美国区所列首次发布日期和1.3版本更新日期均为2023年2月20日。[1]
儿童学习设计将常用词、简短释义和图示结合。 官方介绍记载,应用于2023年在西藏基金会支持下面向初学藏文的儿童编制,按词语常用程度组织内容,提供拼读或连读方式,并为部分词条配图。图示与简明释义可帮助儿童把文字同具体事物联系起来,支持早期藏文词汇学习。[2]
基础教育用途同时延伸至Android设备。 Google Play将Monlam Elementary Dictionary定位为藏文初学者和小学使用的词典;2026年10月24日,其累计下载量处于10K+档位。[3]
2.3.6.9 Lamdre Tsigzoe:宗教术语
专业术语解释服务佛典阅读。 Lamdre Tsigzoe Original围绕宗教、佛教及相关传统提供术语查询和详细释义,解释结合教义与文本语境。[4]
使用对象覆盖研究与专题学习。 商店介绍面向学者、相关实践者及希望理解经典、教义概念的读者。该应用于2024年12月12日发布,1.0版本于次日更新。[4]
专题词典把萨迦方面的编纂成果转为应用内容。 Monlam官方介绍记载,该产品于2024年由Monlam ITRC与萨迦方面的编纂团队共同制作发行,集中整理相关典籍和教义中的术语、解释。专业概念与其文本语境一同进入查询,可为专题阅读、教学和术语解释提供集中参考。[5]
Android版本补充了专业读者的访问渠道。 Google Play上的对应产品名为Lamdre Tsigzoe,2026年10月24日累计下载量为500+档位,定位于佛教研究者、相关实践者及经典阅读者。[6]
2.3.6.10 Neykor:文化导览
地点信息与音频内容构成文化导览。 Neykor围绕寺院、造像及文化活动组织内容,提供音频导览、地图位置和完整地址。[7]
藏文信息技术开源生态报告第二章 生态格局与资源基础
文化学习与参访构成主要场景。 商店介绍面向计划访问文化地点或了解遗产的用户,以地点、历史与传统信息支持导览。该应用于2025年4月9日发布,1.4.1版本于2026年9月21日更新。[1]
文化机构管理与移动分发共同组织地点知识。 官方资料说明,Neykor由Monlam ITRC开发、由CTA宗教与文化部拥有并管理,网站设置寺院、节庆、造像和圣地四类入口。2026年10月24日,Google Play上的Android版本累计下载量为1K+档位。[2][3]
机构活动和社区旅游为导览内容提供传播场景。 2025年7月2日,Neykor在第十五次藏传佛教宗教会议上推出,该会议共有115名宗教及寺院代表等参加。西藏基金会2024年报将这款多语种应用纳入农村聚居区可持续旅游倡议。地点说明、音频和地图相结合,可将线上文化阅读衔接到实地参访,也为多语种访客了解聚居区寺院提供材料。[4][5]
2.3.7 学习与馆藏服务
Monlam门户与WB Academy提供查询和学习服务。 西藏基金会 2025 年报记载,Monlam 公共门户在 2025 年第四季度处理超过 130 万次请求,服务超过 2.5 万名用户。WeBuddhist 面向文本阅读、学习和社区活动;Sherab 学习平台组织课程、测验、论坛与学习进度,其对应 iOS 客户端现以 WB Academy 名称展示。[6][7]
WeBuddhist在持续活动中形成日常使用。 团队公布的2026年9月25日至10月15日活动报告按PostHog统计,应用21天累计用户3,484人,日均活跃用户984人,10月10日峰值为1,261人。同期有1,948人使用阅读器。[8]
藏文信息技术开源生态报告第二章 生态格局与资源基础
英藏汉内容把跨语种阅读与远程参与连接起来。 该期“宗萨21天度母法会与教学”活动提供英语、藏语和汉语标题,活动界面语言分布分别为66%、17%和17%;1,528人进入直播,累计观看1,319.7小时。[1]
数字图书馆将语言技术接入馆藏管理。 藏人行政中央(Central Tibetan Administration,CTA)宗教与文化部组织数字图书馆项目,Wadhwani AI 与 Monlam ITRC 参与技术实施;藏文图书馆管理系统(Tibetan Library Management System,TLMS)连接目录、二维码、扫描及业务管理。项目首年公告记载,在 20 家机构开展培训,为 2,000 个书架和 70,000 部母本完成二维码集成;2026 年 3 月联盟会议报道列示参会机构49家。[2][3][4]
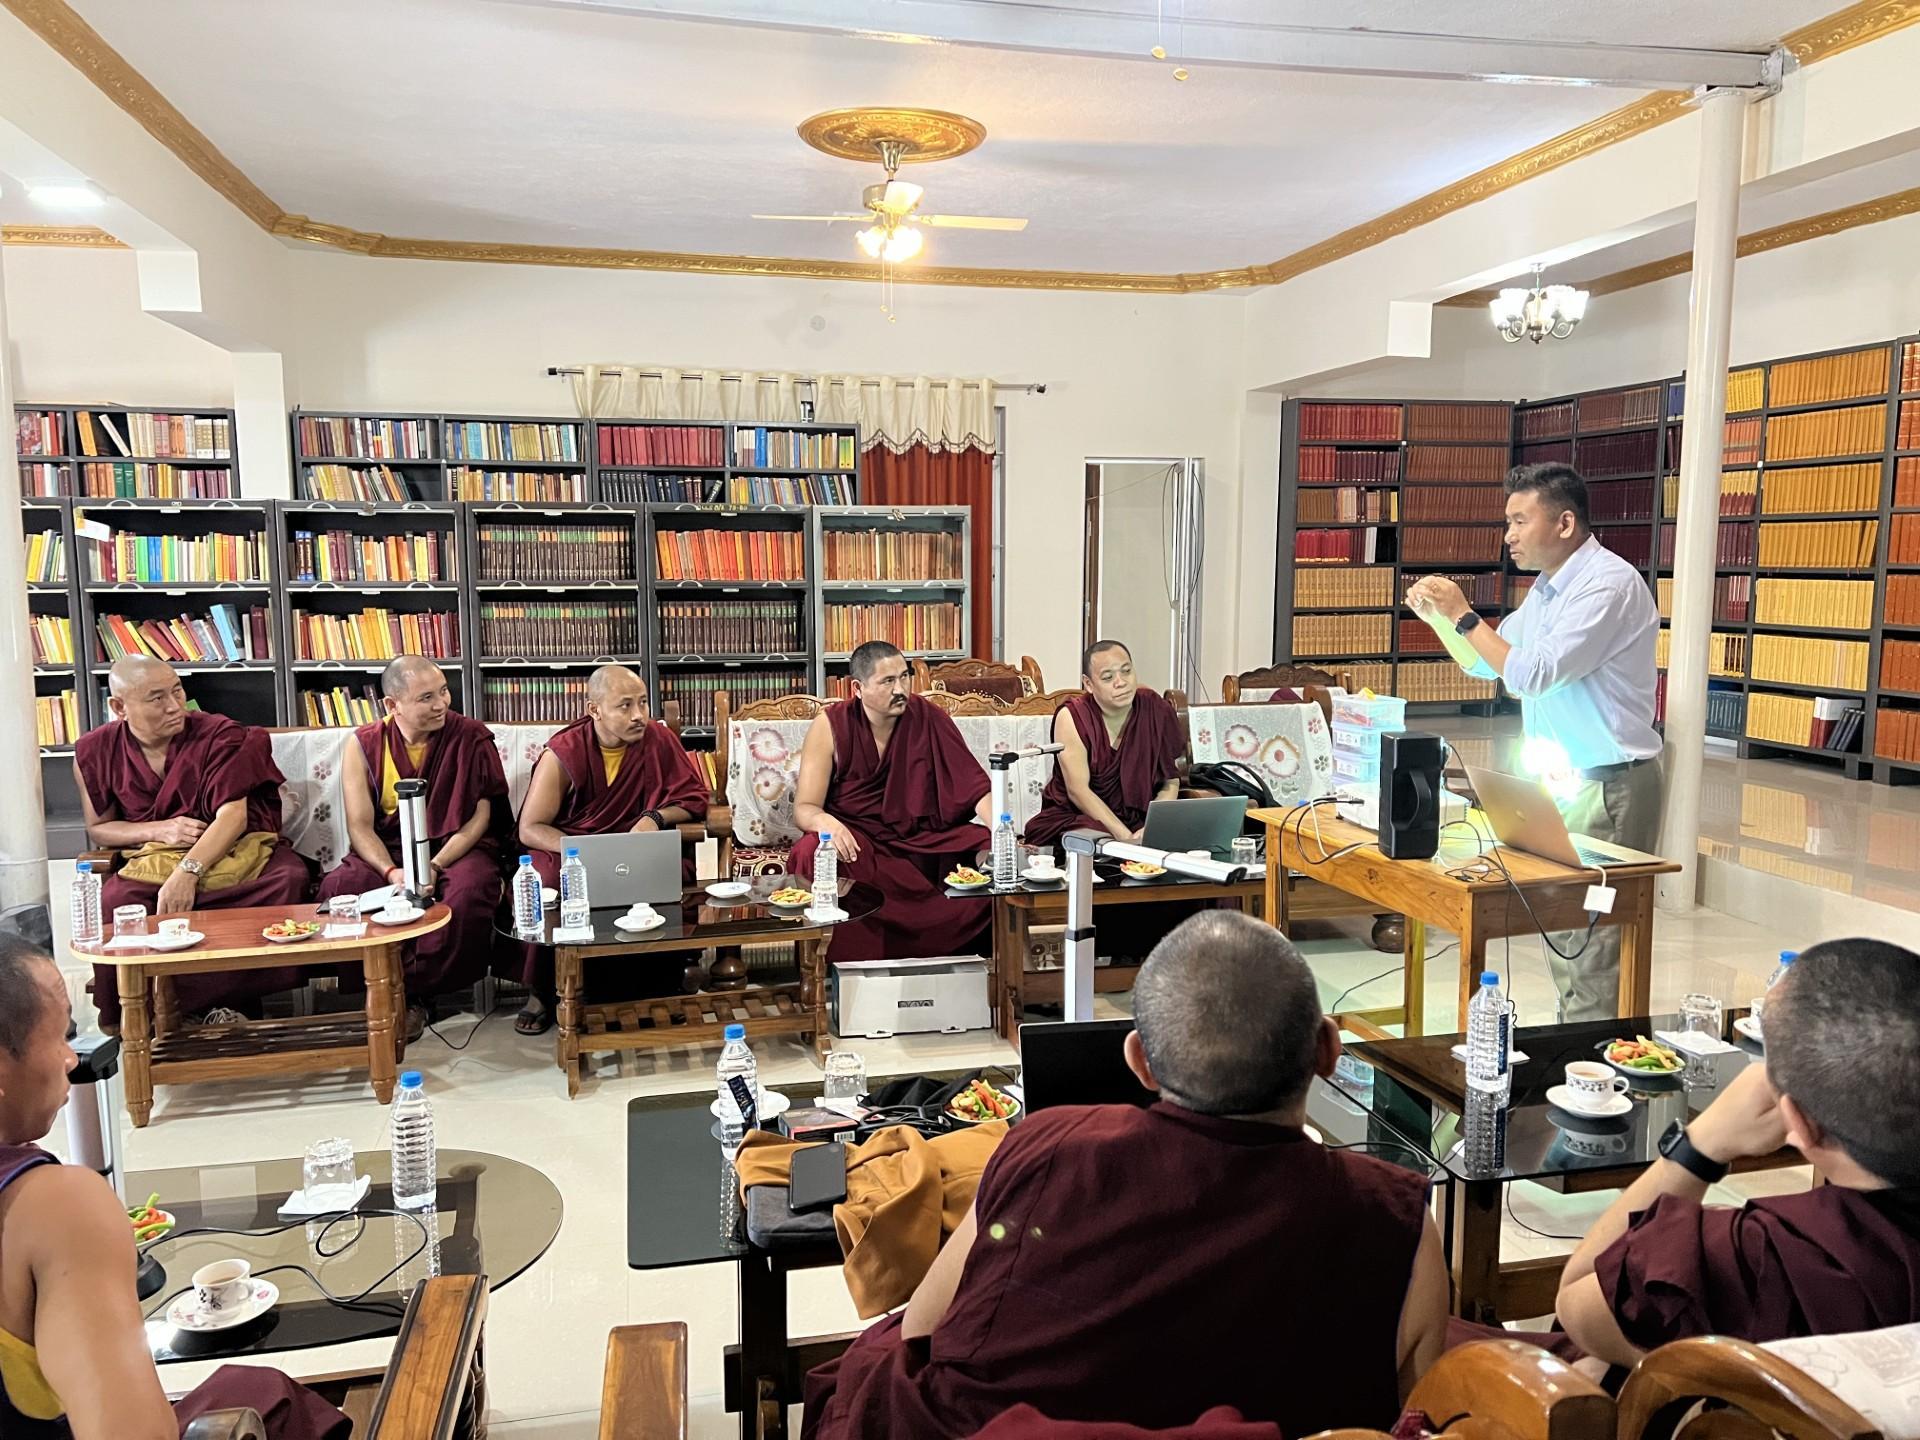
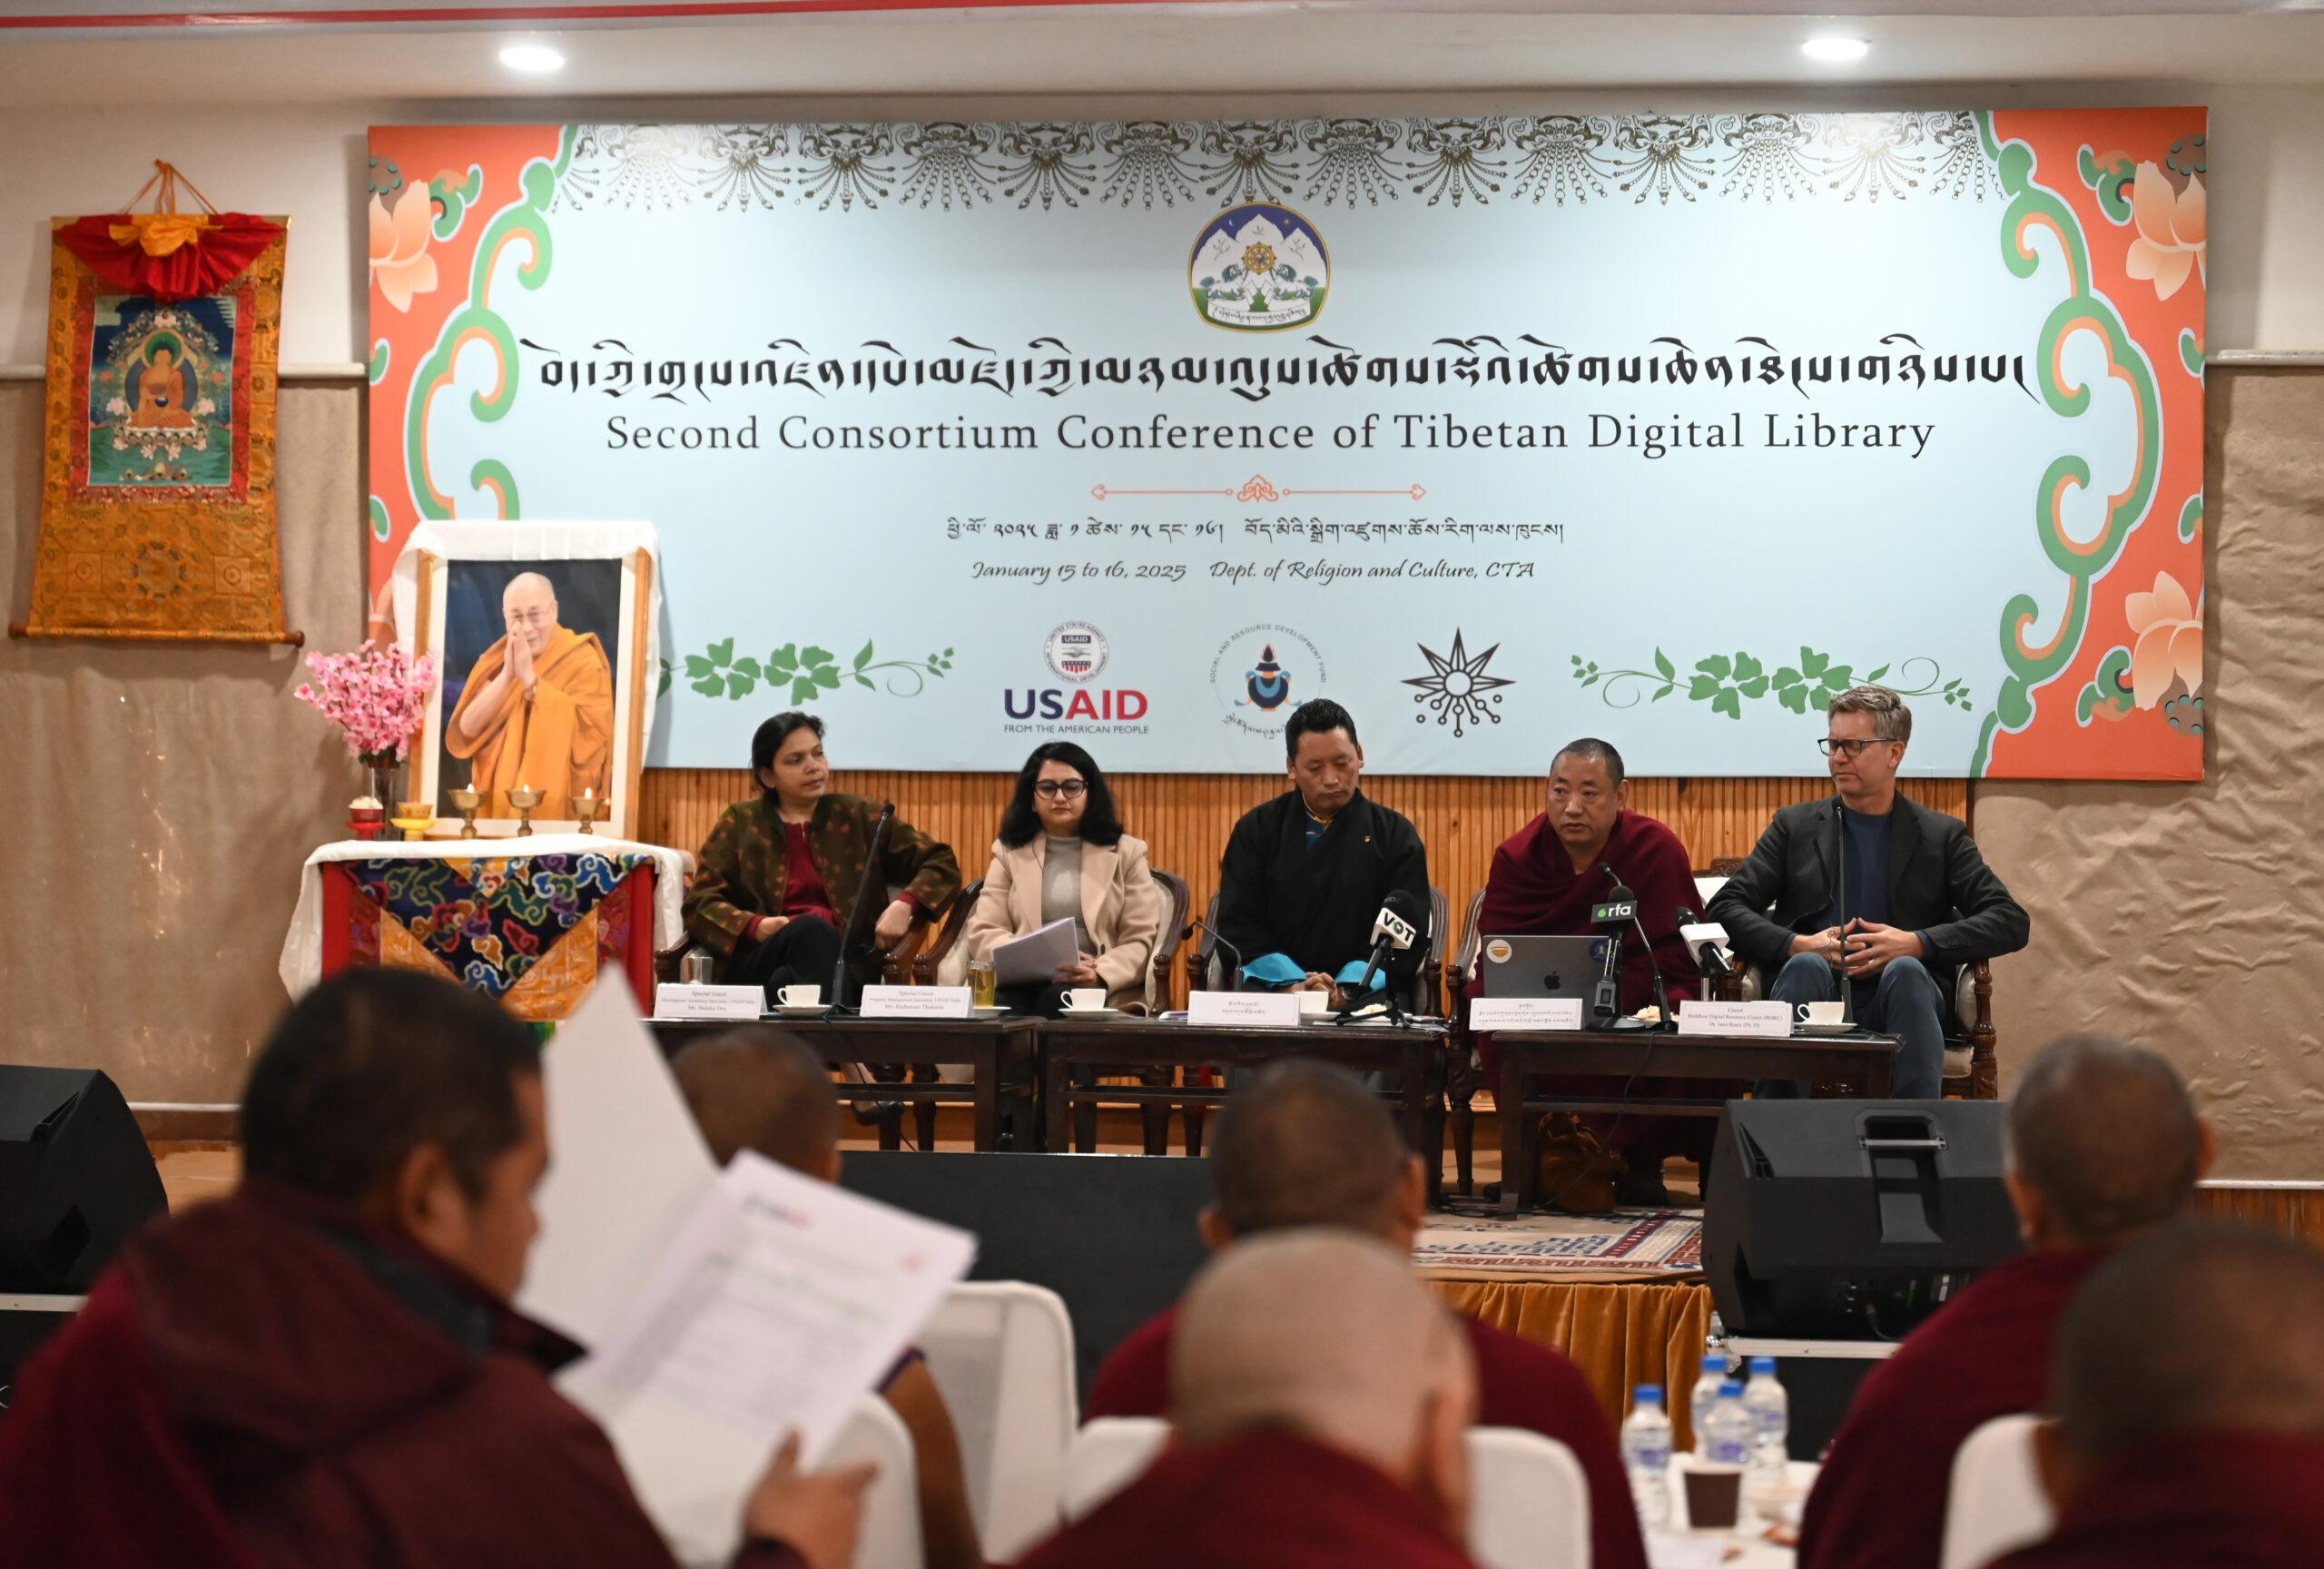
联盟会议把平台开发、文献加工与机构反馈放在同一议程中。 2025年1月15—16日,CTA宗教与文化部联合Wadhwani AI、Monlam ITRC举办第二届联盟会议,约58人参加;议程包括目录系统、数字图书馆原型及典籍数字化。[6]
藏文信息技术开源生态报告第二章 生态格局与资源基础
2026 年 7 月 14 日至 17 日,西藏文献图书馆(Library of Tibetan Works and Archives,LTWA)举办实体文献保护培训,参加者为来自 17 家机构的 26 人,机构构成为 14 座寺院和 3 家文化机构。[3]
藏文信息技术开源生态报告第二章 生态格局与资源基础
资源创作工具与课程提供了开发者接触内容生产的入口。 Dharmaduta官网将Buddhist AI Tools列为文本创建、编辑与管理套件,pecha.tools提供藏英译后编辑。2026年1月29日至2月6日在菩提伽耶举办的佛教创作者大会连接内容创作者与开发者,Sherab将相关课程转为线上教学。[1][2][3]
活动后台将项目展示与技术培训组织起来。 Monlam 慈善信托(Monlam Charitable Trust)网站仓库设置项目、工作坊、媒体和管理等模块。工作坊记录分别介绍文本与图像标注、软件开发及版本协作等课程,达赖喇嘛高等教育学院(Dalai Lama Institute for Higher Education,DLIHE)的 2025 年 2 月院刊记载了软件工程实训合作。[4][5][6]
2.3.8 国内能力与资源
DeepZang以平行语料和方言语音支持产品服务。 西藏自治区经济和信息化厅2026年公开动态记载,DeepZang于3月15日发布,由西藏觉罗数字产业管理有限公司研发,完成深度合成服务算法备案与生成式人工智能服务备案;所列规模为近7,000万条藏语平行语料和超过30,500小时三大方言语音。[7]
藏文信息技术开源生态报告第二章 生态格局与资源基础
文献保护和跨学科人才积累继续支撑国内资源建设。 新华社 2026 年报道记载,西藏大学教授拥措(Yong Tso)于 1998 年加入尼玛扎西团队,2017 年主持该校国家重点研发项目,研究连接算法、藏文及医学文献,并指导 40 余名硕博研究生。布达拉宫贝叶经等古籍文献保护利用项目的同期进展列有 3.6 万叶数字化采集与文字识别,累计投入 1.104 亿元人民币,一、二期已验收,三期计划于2026年底验收。[1][2]
语料与训练研究正按完整开发流程组织。 电子科技大学、西藏大学等团队的藏文基础数据集(Tibetan Foundation Dataset,TFD)论文在 2026 年 5 月版本中,统一介绍 TIBSTC、TIBSTC-CoT 和 Sun-Shine 模型系列,覆盖预训练、指令、安全、偏好和推理数据。天津大学团队在 ACL 2026 发表的研究则围绕 72 GB 藏文语料,以 Qwen2.5-7B 开展多语持续预训练,并扩展至混合专家模型。[3][4]
TFD论文的预训练Corpus子集列有122,756,184条实例、11B词元(约110亿)及18GB数据。[3]
藏文信息技术开源生态报告第二章 生态格局与资源基础
表2-5 国内主要产品与研究资源的量化记录(续)
| 产品或研究 | 来源所列规模或技术路线 | 资料与应用形式 |
|---|---|---|
| TFD/Sun-Shine | TIBSTC综合资源超过110亿词元,预训练Corpus子集约110亿词元;配套指令、安全、偏好数据,TFD另含TIBSTC-CoT推理数据 | 论文与项目介绍[1] |
| 天津大学藏文持续预训练研究 | 72 GB语料,Qwen2.5-7B基座,扩展50B-A10B混合专家模型(约500亿总参数、100亿激活参数) | ACL 2026论文[2] |
| FTibSuite | 数据FTibData、评测FTibBench、基于Qwen3-VL-8B-Instruct的FTibVLM | 三阶段视觉语言适配研究[3] |
| Ti-Audio | 多方言端到端语音语言模型,动态Q-Former适配 | 语音识别、翻译及语音任务研究[4] |
| MiLiC-Eval | 论文约2.4万条实例、9项任务,覆盖4种语言 | ACL 2025 Findings论文、数据与评测程序[5] |
| 少数民族语言标题生成(Chinese Minority Headline Generation,CMHG) | 藏文100,000条、维吾尔文和蒙古文各50,000条 | EMNLP 2025论文及公开数据入口[6] |
藏文信息技术开源生态报告第二章 生态格局与资源基础
表2-5 国内主要产品与研究资源的量化记录(续)
图文与语音研究扩展任务能力。 FTibSuite 由中央民族大学、上海交通大学和中国科学院自动化研究所等团队提出,组织图文数据、藏文多模态评测及基线模型。论文报告中,FTibVLM 的 MMBench 准确率由基座的 42.97% 提高至 67.78%,POPE-random 由 47.53% 提高至 80.56%,BinaryVQA 为 76.01%。Ti-Audio 由中央民族大学与香港中文大学(深圳)等团队研究,通过动态 Q-Former 对齐语音和文本特征。[4][5]
公开资源提供了多任务研究与应用入口。 MiLiC-Eval项目同时发布代码、数据划分和评价脚本,研究涵盖四种语言、九类任务。[6]
标题生成数据形成了专题训练资源。 CMHG论文提供藏文100,000条、维吾尔文和蒙古文各50,000条标题生成样本。[7]
资源、工具、模型和终端共同构成实际供给。资产规模体现可投入的材料,训练采用体现技术作用,用户和机构记录体现服务使用;维护这些成果还需要持续的人员、存储、计算和现场支持。
藏文信息技术开源生态报告第二章 生态格局与资源基础
2.4 资金与运作
资金沿两条线索进入技术生态:政府协议按项目和执行节点追加,再通过次级资助进入执行机构;基金会、私人支持与经营收入共同承担研发和日常成本。机构财务呈现2024年收入上升、2025年回落而文化用途支出持续增加的变化。
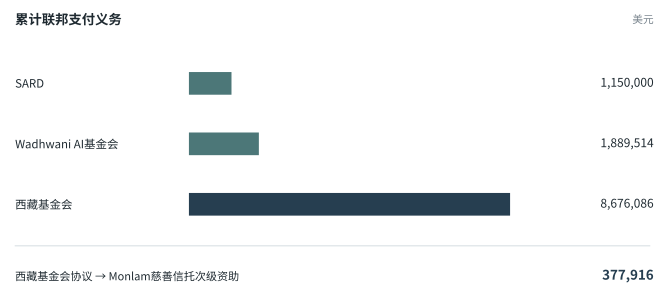
三项协议的资金按执行节点分次追加。 三项协议的新增联邦支付义务按已列交易归集:2023年为2,439,514美元,2024年为6,578,000美元,2026年为2,698,086美元,合计11,715,600美元。资金再由主协议连接次级资助,Monlam慈善信托两笔报送合计377,916美元。[1][2][3][4][5][6]
2.4.1 协议与次级资助
SARD的项目筹资能力在直接资助建立前已持续扩大。 2019—2020年报记载,机构年度项目获资额由2016年的290万美元增至2020年的1,250万美元,员工与顾问由19人增至39人;储备资金由1,270万印度卢比增至3.7亿印度卢比。[7]
藏文信息技术开源生态报告第二章 生态格局与资源基础
2020年直接资助将语言内容与机构能力建设纳入同一项目。 2020年6月23日,USAID向SARD授予997,124美元,由当时的主任Kaydor Aukatsang代表SARD/CTA签署两年期Tibetan Resilience Project合作安排。教育部承担藏语振兴部分,涉及动画、有声书、六至十二年级儿童读物、学习门户及青年语言文化活动;SARD负责Gangjong Development Finance的业务规划、管理信息系统和培训。[1]
较早项目的结项资料延续到2023年。 USAID监察长办公室2024年6月备忘录列明,SARD所管理的Tibetan Resilience Project协议为72038620CA00008,结项审计期间覆盖2022年4月1日至2023年4月22日;同一备忘录还列有AID-386-G-16-00001项下次级资助,以及22-21112A-TIB.0-2251能力建设项目。[2]
藏文信息技术开源生态报告第二章 生态格局与资源基础
藏文信息技术开源生态报告第二章 生态格局与资源基础
五年期计划为经济、社会和文化项目提供持续安排。 西藏基金会 2025 年审计附注列示,“南亚藏人社区自立与韧性计划”(Program for Self-Reliance and Resilience of Tibetan Communities in South Asia)对应协议 72038624CA00006,计划期为 2024—2029 年,计划资助额 30,000,000 美元;截至 2025 年末,累计会计确认收入为 2,585,831 美元,可用资助余额为 27,414,169 美元。[1]
Monlam两笔次级资助占该组报送金额的4.72%。 截至2026年10月23日,主协议72038624CA00006列有37条次级资助报送,合计8,011,625美元;其中Monlam慈善信托两条合计377,916美元。[2][3]
表2-7 主协议72038624CA00006项下Monlam慈善信托的次级资助报送(单位:美元)
藏文信息技术开源生态报告第二章 生态格局与资源基础
藏文信息技术开源生态报告第二章 生态格局与资源基础
表2-8 西藏基金会2023—2025年收支、文化项目与年末财务状况(单位:美元;审计报表)(续)
| 指标 | 2023年 | 2024年 | 2025年 |
|---|---|---|---|
| 其中:捐款收入 | 2,584,113[1] | 7,245,542 | 4,961,661[2] |
| 总支出(活动表列示费用) | 11,828,030[1] | 13,197,165 | 12,406,742[2] |
| 文化和宗教保护/文化遗产保护支出 | 3,255,698[1] | 3,722,492 | 6,679,975[3] |
| 按费用性质列赠款及捐助支出 | 10,164,418[1] | 11,333,204 | 10,688,076[3] |
| 年末现金及现金等价物 | 774,359[1] | 5,665,422 | 1,818,185[4] |
| 年末总资产 | 9,682,601[1] | 14,429,768 | 12,284,575[2] |
| 年末净资产 | 8,460,085[1] | 13,019,562 | 10,899,053[2] |
藏文信息技术开源生态报告第二章 生态格局与资源基础
现金积累集中在2024年,2025年出现较大消耗。 年末现金从2023年的774,359美元升至2024年的5,665,422美元;2024年余额中5,000,000美元为受捐赠用途限制的现金。2025年现金降至1,818,185美元,下降67.91%,净资产减少2,120,509美元。2024年、2025年末现金占相应年度支出的比例分别为42.93%、14.65%;2025年末一年内可用于一般支出的金融资产为8,771,978美元,包含现金、投资和应收款等。[1][2][3][4]
藏文信息技术开源生态报告第二章 生态格局与资源基础
私人支持承担了数字图书馆项目资金短缺期间的人员成本。 藏人行政中央(Central Tibetan Administration,CTA)2026 年 3 月第三届藏文数字图书馆联盟会议报道回顾,上一年度资金短缺期间,意大利资助者 Alessia Bulgari 提供了项目员工一年的工资支持。[1]
私人资助者的文化与公益经历延伸至项目人员支持。 Alessia Bulgari曾参与《小活佛》的剧照摄影;2017年出版资料介绍,她是2008年成立的Pianoterra的联合创办人和主席,摄影集《Little Ones》的收益用于该机构。Emory University的Compassion Shift项目也将其列为捐赠人。2026年数字图书馆会议所记的一年工资支持,把这一私人公益资金来源连接到馆藏项目的日常运营。[2][1]
美国2026财年拨款设置文化、社区和行政能力用途。 美国于 2026 年 2 月 3 日签署的 Public Law 119-75《2026 年综合拨款法》第 7043(k) 条,列明至少 10,000,000 美元用于中国境内藏人社区的文化传统保护、可持续发展、教育和环境保护;至少 8,000,000 美元用于难民及离散藏人社区文化语言保护、发展和韧性等项目;至少 5,000,000 美元用于 CTA 能力建设,其中最高 1,500,000 美元安排于相关经济增长和能力建设用途。三类最低拨款合计 23,000,000 美元。[3]
2.4.4 现金与专业投入
专业工具由资金、人员和数据整理共同建设。 藏文批处理工具 pybo 的项目说明列明,钦哲基金会(Khyentse Foundation)提供 22,000 美元启动资助,佛教数字资源中心(Buddhist Digital Resource Center,BDRC)提供两名人员参与六个月数据整理,Barom/Esukhia 典籍项目支持训练数据整理。[4]
藏文信息技术开源生态报告第二章 生态格局与资源基础
基金会投入覆盖翻译和文本保存等上游环节。 钦哲基金会 2025 年报财务摘要的统计期间为 2024 年 7 月 1 日至 2025 年 6 月 30 日,其中翻译支出为 1,508,874 美元,文本保存支出为 471,828 美元。受助项目分类在文本保存项下列 BDRC,在翻译项下列 Esukhia Canada。[1][2]
BDRC审计报告列示机构年度收支及资产。 BDRC 的 2024 年审计报告列示,全年收入及支持总额为 2,195,554 美元,支出为 2,147,535 美元,年末总资产为 3,783,976 美元。[3]
新的数据资助把文献加工与人工智能开发连接起来。 BDRC 于 2026 年 2 月公告,钦哲基金会支持的开放佛教数据集计划自 2025 年 12 月开始,安排延续至 2027 年夏,目标是加工数百万页文献、形成数万份标准化电子文本,并面向人工智能开发者发布。[4]
人员协作使语料整理和模型开发获得持续的专业支持。 西藏基金会 2023 年报记录,Monlam 相关项目有来自印度高校和寺院的 320 余名藏人参与兼职工作,并得到谷歌、加州大学伯克利分校和汉堡大学专家协作。[5]
Dharmamitra将基金会合作、学术项目资金与计算资源汇聚到研发任务。 Tsadra Foundation与Dharmamitra开展三年佛典翻译和研究工具合作;2025年Schmidt Sciences的HAVI项目把Nehrdich所在团队与哈佛大学Peter Bol牵头的欧亚文本检索研究连接起来。2026年6月22日,Dharmamitra公告获日本文部科学省AI for Science(SPReAD)500万日元支持,用于《国译一切经》等文献及佛典知识图谱,并获得大阪大学SQUID高性能计算集群优先使用安排。[6][7]
2.4.5 经营与捐赠渠道
技术与数据服务被纳入社区投入和持续经营安排。 Dharmaduta 的经营说明提出,将相关服务利润的 70% 用于社区发展、30% 用于可持续经营,并将创作者活动纳入支持范围。[8]
藏文信息技术开源生态报告第二章 生态格局与资源基础
公开捐赠咨询连接社区支持与基础设施维护。 OpenPecha 官网设置 25、50、100、250、500、1,000 美元及其他金额的捐赠意向选项,通过咨询表接收支持意向,列明社区赠款和基础设施维护等用途。[1]
藏文信息技术开源生态报告第二章 生态格局与资源基础
社区资助把技术人员的组织能力转为开放内容。 Tenzin Kaldan组织的藏文维基编辑与校对项目获支持432,000印度卢比。项目方2026年5月提交的成果报告列报支391,925印度卢比,活动期为2025年11月至2026年4月,覆盖7个场地、300名参与者和9名组织者;藏文Wikipedia新增546页、改进668页,Wikisource新增546页、改进680页。[1][2]
2.4.6 拨付与项目交付
数字图书馆项目将行政组织、受款安排和技术实施连接起来。 CTA 宗教与文化部负责机构协调,SARD 与 Wadhwani 人工智能基金会分别持有 2023 年合作协议,Wadhwani AI 承担主要技术工作,Monlam ITRC 参与数字资源库开发、培训和分类框架建设。首年公告记录培训和二维码编目,2026年联盟会议记录49家项目参与机构参会。[3][4][5][6][7]
基金会的项目管理程序将拨付与进展报告相衔接。 西藏基金会 2023 年税务申报补充说明列有管理层审查受助方及项目、董事会批准年度预算、准备书面赠款协议、签署后拨付,以及季度财务和项目报告等环节;美国政府资助项目另有现场访问和年度合规审计安排。[8]
项目资金、机构收支和专业投入各自承担不同作用。协议追加支持阶段建设,文化支出及次级资助继续流向执行机构,工资与技术岗位维持日常更新;资金变化由此能够传到数据生产和产品维护。