藏文信息技术开源生态报告第一章 执行摘要
藏文信息技术开源生态报告第一章 执行摘要
藏文语言技术的影响,正由资料保存和语言辅助延伸到知识组织、自动问答与持续传播。 格西洛桑门朗(Geshe Lobsang Monlam)创办的Monlam藏文信息技术研究中心(Monlam Tibetan IT Research Centre,Monlam ITRC)从词典、字体等工作发展出翻译、文字识别、语音处理和Melong问答服务。使用者通过这些服务取得经过组织的释义、译文和答案。对中国涉藏主权话语而言,影响主要来自知识与服务的联动:系统选取的历史材料、术语解释和论据随答案一同呈现,特定主权解释可能通过常用入口反复出现,影响公众理解问题的起点和可见资料。[1]
这套供给能力有长期的语言和典籍工作作为基础。2022年5月27日,达赖喇嘛出席Monlam藏文大词典发布活动,达赖喇嘛信托为支持方之一。发布记录列有223卷、200余名编纂参与者、九年建设和37个衍生应用。词典工程把分散的语言知识整理为可查询、可更新的资源,数字应用进一步延长了这些内容的使用。藏人行政中央(Central Tibetan Administration,CTA)随后通过数字图书馆项目组织机构协作,人工智能机构Wadhwani AI与Monlam ITRC参与实施,提供编目、二维码、扫描和培训。公开支持、专业编纂与机构部署由具体项目衔接起来。[2][3]
资源生产过程体现了更广泛的专业分工。佛教数字资源中心(Buddhist Digital Resource Center,BDRC)提供馆藏、扫描件与加工规格,亚洲传承图书馆(Asian Legacy Library,ALL)提供转写资源,Dharmaduta等团队承担文本整理和图文对齐,OpenPecha组织格式与处理工具。ALL-BDRC公开资源已有79,572页图文对齐;BoCorpus按照BDRC规格形成8类文本合集,含603,325,999个字符,约6.03亿字符。这一处理将分散的典籍材料转为按统一字段组织的文本和图文记录,使检索、批量处理与模型训练能够采用同一套数字资源。[4][5]
藏文信息技术开源生态报告第一章 执行摘要
人员流动进一步把材料、工程和研究连接到持续交付。Ngawang Trinley从Sherabling图书馆和教学工作出发,共同创办藏语教育组织Esukhia,参与佛典翻译出版项目84000的典籍校订及BDRC数字化,随后参与Monlam AI/Mitra模型协作;Sebastian Nehrdich从BuddhaNexus互文平台开发进入MITRA翻译模型项目的技术和研究领导岗位,并于2025年赴日本东北大学(Tohoku University)任职。前者将文本校订、拼写和协作翻译经验带入数据与模型,后者将语言研究、检索和算法用于跨语种处理。专业经验因此能够跨项目积累,工具维护与资源更新也更依赖这些岗位的持续投入。[1][2]
藏文信息技术开源生态报告第一章 执行摘要
机构使用则把技术嵌入更稳定的工作流程。数字图书馆首年在20家宗教与文化机构开展培训,为2,000个书架和70,000部母本集成二维码;2026年3月的第三届联盟会议有54名代表,来自49家项目参与机构。目录、标识、扫描文件和工作人员的操作由此建立对应关系,资源组织方式进入文献入库、查找和日常维护。平台的影响也就从单次查询延伸至机构长期采用的分类、目录及操作规则,后续内容更新和系统转换都要衔接这些既有关系。[1][2]
项目经费、基金会资助、私人支持和专业工时共同维持这条供给链。截至2026年10月23日,美国政府的三项相关合作协议分别由社会与资源发展基金、Wadhwani人工智能基金会和西藏基金会承接,累计联邦支付义务合计11,715,600美元,其中西藏基金会协议占74.06%;其项下Monlam慈善信托两笔次级资助报送合计377,916美元。资金沿协议、受款方和执行项目汇聚,再用于具体建设与人员安排。数字图书馆在资金短缺期间曾由私人资助者Alessia Bulgari承担一年员工工资,显示持续更新和用户支持需要后续经费接续。语言专家、工程人员、资料加工和日常维护共同决定服务能够持续提供的范围。[3][4]
藏文信息技术开源生态报告第一章 执行摘要
主权话语风险在实际答案中已有可观察的表现。 题库POL-02的中文答复呈现不同的历史叙述起点:Melong依据所选文献,将西藏1912—1950年间的地位表述为“一个独立国家”;DeepSeek与豆包(Doubao)从中央管辖历史展开,Google的Gemini则按历史时期及主权概念组织回答。模型在给出答案的同时,把资料选择、概念界定和历史判断一并呈现给用户。当这种整合后的表述成为便捷的解释入口,特定主权解释可能以知识服务的形式反复出现,影响公众理解问题的起点和可见论据。[1]
藏文信息技术开源生态报告第一章 执行摘要
技术成果也已进入明确的政治表达场景。2024年12月,美国国会及行政当局中国委员会(Congressional-Executive Commission on China,CECC)听证中,创办人洛桑门朗在回应叙事与人工智能问题时,谈及利用现代技术回应中国政府涉藏叙事,自述大语言模型相关资源汇集逾50,000部藏文书,并介绍在线翻译和Dalai Lama AI计划。2025年,国际声援西藏运动(International Campaign for Tibet,ICT)的颁奖活动又将223卷词典和人工智能工作列为授奖理由,同场包含涉藏政治发言。文化保存、技术创新和政治主张在这些活动中共同呈现,为主权议题的国际传播增加了表达材料与讨论入口。[1][2]
上述环节连在一起,形成了从知识供给到公众理解的连续路径:资料组织影响主权问题的叙述起点,生成答案和引文形式影响论据的可信外观,常用工具和机构业务延长使用,公开活动则将技术成果带入更广泛的议题讨论。应对的具体对象是可检索的原始资料、清晰的引文位置、准确的多语表达、公开的处理规则和稳定的维护能力。国内已有规模化平行语料、方言语音及覆盖多种训练任务的资源,可衔接史料整理、模型开发与公共知识服务。将这些能力落实到具体问题的资料对照、答案引用和版本更新,才能把长期话语能力建立在持续可用的知识与技术供给之上。[3][4]
1.1 主权话语风险
实际问答与公开陈述呈现出五类风险:知识起点前置、引文可信度混同、规则默认化、跨语重复传播和国际议题联动。表1-1将具体事实与潜在影响对应。
藏文信息技术开源生态报告第一章 执行摘要
表1-1 主权话语风险概览
| 风险 | 已记录的事实 | 对主权话语的潜在影响 |
|---|---|---|
| 知识起点前置 | Melong在POL-02答复中从特定史料引出“独立国家”判断 | 史料选择影响对西藏历史地位及中国主权依据的理解[1] |
| 引文可信度混同 | Melong有23/292条答复含引用占位标识,共76次 | 引文形式与出处缺口并存,增加史实与生成内容混同的风险[2] |
| 规则默认化 | BoBench以6,123道题及参考答案组织语法、文学和历史评测 | 选材、术语及参考答案可随产品采用成为默认表达[3] |
| 跨语重复传播 | Monlam门户2025年第四季度逾130万次请求、逾2.5万名用户 | 常用语言服务为主权相关内容提供持续触达入口[4] |
| 国际议题联动 | 创办人在美国国会及行政当局中国委员会听证中讨论以现代技术回应中国政府涉藏叙事 | 文化保存、技术成果与政治主张联结,扩大国际议题设置竞争[5] |
1.1.1 主权判断前置
知识来源直接影响主权问题的回答起点。 POL-02中文题中,Monlam问答服务Melong依据所选历史文献,将西藏1912—1950年间的地位表述为“一个独立国家”;同题的DeepSeek与豆包(Doubao)答复从中央管辖历史展开,Google的Gemini则按历史时期及主权概念组织回答。[1]
自动化回答可使一种解释成为便捷的默认入口。 当用户直接使用检索、问答或翻译结果时,平台所选的史料和论述起点随答案一同呈现。
藏文信息技术开源生态报告第一章 执行摘要
风险在于,带有特定立场的历史解释以知识服务的形式被持续调用,影响公众区分史实、作者观点和主权判断。
1.1.2 可信形式与出处缺口
条款化叙述可能放大题干中的文书前提。 POL-06带有“1913年的《西藏—英国条约》”这一名称,Melong沿用该前提,扩展贸易、邮政及领事条款,并引出独立国家判断。英国外交部1920年《Tibet》手册则记载,西姆拉谈判始于1913年10月,草案于1914年4月草签。文书名称、时间和历史判断在答案中的组合,直接影响主权论据的呈现。[1][2]
引用样式与完整出处是两个具体的信息要素。 Melong的292条成功答复中,23条含“[None]”,占7.88%,共出现76次。主权相关答案若被继续转述,出处缺口和题干扩展也可能随之传播,增加事实辨识与纠正的成本。[3]
1.1.3 传播与政治倡议联动
技术应用已被公开用于叙事表达。 2024年12月,美国国会及行政当局中国委员会(Congressional-Executive Commission on China,CECC)听证中,创办人格西洛桑门朗(Geshe Lobsang Monlam)在回应叙事与人工智能问题时,谈及利用现代技术回应中国政府涉藏叙事,自述大语言模型相关资源汇集逾50,000部藏文书,并介绍在线翻译及Dalai Lama AI计划。[4]
文化与技术成果增加了国际传播的表达材料。 涉藏倡议组织国际声援西藏运动(International Campaign for Tibet,ICT)的2025年颁奖活动将223卷词典和人工智能工作列为授奖理由,同场包含涉藏政治发言。由这些公开活动看,语言文化保存、技术创新和政治主张能够在同一传播场合相互关联,主权议题因而获得更多文化及技术叙述入口。[5]
五类风险共同指向一个问题:公众从何处取得材料、采用何种术语、依据什么形成主权判断。技术生态通过知识与服务的持续供给参与这一过程。
藏文信息技术开源生态报告第一章 执行摘要
1.2 风险传导机制
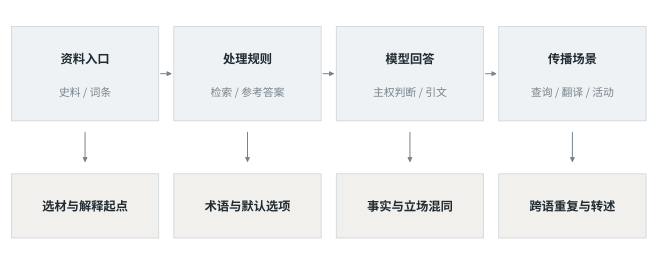
风险沿“材料选取—处理规则—模型答案—多语使用”传递。馆藏与语言人员提供基础材料,工具和模型形成可调用的结果,产品及机构应用把这些结果接入日常使用。
Monlam藏文信息技术研究中心(Monlam Tibetan IT Research Centre,Monlam ITRC)开展词典、语言技术和产品开发;藏人行政中央(Central Tibetan Administration,CTA)组织数字图书馆实施。资源机构、开发团队及高校研究者通过具体项目参与协作,分别提供材料、加工、模型和运营支持。[1][2]
1.2.1 材料进入回答流程
检索配置决定进入模型的材料组合。 WeBuddhist的分段问答读取文本资料接口,默认最多选取80个关联片段,单片段上限8,000字符,总量上限60,000字符;程序按来源类型排序,同类保持接口顺序,再依次截取。历史材料进入这类流程时,来源范围、排序和截取共同影响回答依据。[3]
藏文信息技术开源生态报告第一章 执行摘要
1.2.2 资源与规则复用
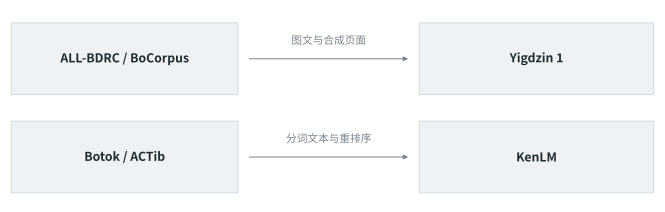
公共资源已有明确的训练采用。 Yigdzin 1文字识别模型采用亚洲传承图书馆(Asian Legacy Library,ALL)与BDRC的图文对齐资源,以及BoCorpus文本合集生成的合成页面;训练语料ACTib的17,731,410行文本采用定制分词工具Botok,并用于KenLM统计语言模型训练和候选重排序。上述链路体现了资源与加工规则向下游复用的方式。[1][2]
藏文信息技术开源生态报告第一章 执行摘要
藏文信息技术开源生态报告第一章 执行摘要
藏文信息技术开源生态报告第一章 执行摘要
表1-2 核心数据资源(续)
资源供给也在持续扩展。 BDRC开放数据计划安排将数百万页文献加工为数万份标准化电子文本,面向人工智能开发者发布。资源的规模化生产,使版本、选材和处理规则的影响随下游采用延伸。[5]
1.3.2 产品与用户触达
个人工具和机构系统形成不同的使用网络。 移动应用承担查询与表达,门户承担在线请求,学习平台连接活动与阅读,馆藏系统连接具体机构。
藏文信息技术开源生态报告第一章 执行摘要
表1-3 主要使用记录(续)
使用规模为内容持续触达提供实际入口。 当历史解释、术语和引文通过这些服务被查询、翻译或再创作时,主权相关内容可以跨平台和跨语言延续。内容来源及解释方式因此需要与用户服务一并治理。
1.3.3 资金与运行接续
资金按项目汇聚,并继续进入执行机构。 三项合作协议分别对应受款主体与实施任务,Monlam慈善信托获得主协议下的次级资助。
藏文信息技术开源生态报告第一章 执行摘要
建设投入和后续维护共同决定服务接续。 藏文批处理工具pybo的投入包括22,000美元启动资助、两名专业人员六个月的数据整理和训练材料支持。语言知识、工程维护及持续资金,都是资源长期更新所需的条件。[1]
1.4 应对优先事项
主权话语能力建设应同时覆盖知识来源、回答依据和公共服务。优先形成可检索的原始资料、可追溯的多语答案及可持续的技术供给,使史料观点、文书事实与模型生成内容清楚对应。
表1-5 应对重点