藏文信息技术开源生态报告
技术生态、主权话语与风险治理
典籍、词典与模型服务形成跨机构供给网络。主权话语风险贯穿知识选择、回答生成和多语传播,公共知识、语言工具与持续维护共同支撑长期应对。
报告日期:2026年10月25日;主要数据截至2026年10月25日。
技术生态、主权话语与风险治理
典籍、词典与模型服务形成跨机构供给网络。主权话语风险贯穿知识选择、回答生成和多语传播,公共知识、语言工具与持续维护共同支撑长期应对。
报告日期:2026年10月25日;主要数据截至2026年10月25日。
藏文语言技术的影响,正由资料保存和语言辅助延伸到知识组织、自动问答与持续传播。 格西洛桑门朗(Geshe Lobsang Monlam)创办的Monlam藏文信息技术研究中心(Monlam Tibetan IT Research Centre,Monlam ITRC)从词典、字体等工作发展出翻译、文字识别、语音处理和Melong问答服务。使用者通过这些服务取得经过组织的释义、译文和答案。对中国涉藏主权话语而言,影响主要来自知识与服务的联动:系统选取的历史材料、术语解释和论据随答案一同呈现,特定主权解释可能通过常用入口反复出现,影响公众理解问题的起点和可见资料。[1]
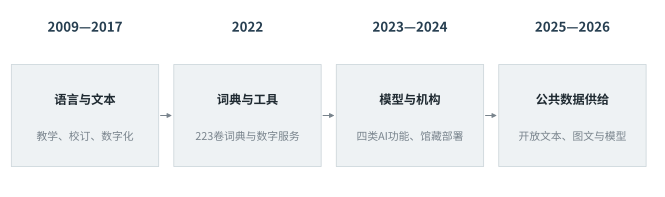
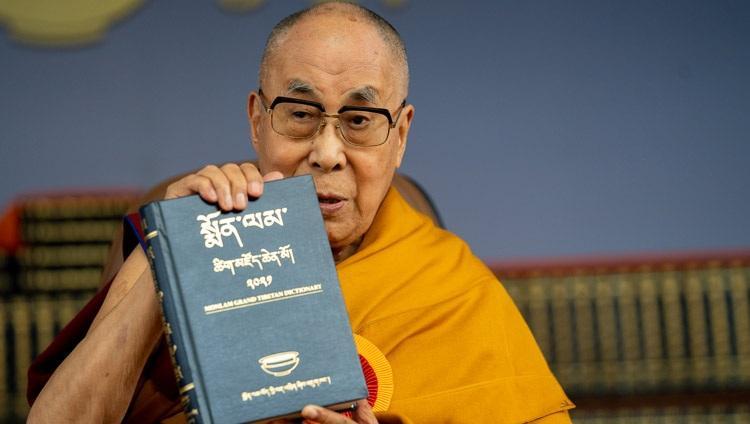
这套供给能力有长期的语言和典籍工作作为基础。2022年5月27日,达赖喇嘛出席Monlam藏文大词典发布活动,达赖喇嘛信托为支持方之一。发布记录列有223卷、200余名编纂参与者、九年建设和37个衍生应用。词典工程把分散的语言知识整理为可查询、可更新的资源,数字应用进一步延长了这些内容的使用。藏人行政中央(Central Tibetan Administration,CTA)随后通过数字图书馆项目组织机构协作,人工智能机构Wadhwani AI与Monlam ITRC参与实施,提供编目、二维码、扫描和培训。公开支持、专业编纂与机构部署由具体项目衔接起来。[2][3]
资源生产过程体现了更广泛的专业分工。佛教数字资源中心(Buddhist Digital Resource Center,BDRC)提供馆藏、扫描件与加工规格,亚洲传承图书馆(Asian Legacy Library,ALL)提供转写资源,Dharmaduta等团队承担文本整理和图文对齐,OpenPecha组织格式与处理工具。ALL-BDRC公开资源已有79,572页图文对齐;BoCorpus按照BDRC规格形成8类文本合集,含603,325,999个字符,约6.03亿字符。这一处理将分散的典籍材料转为按统一字段组织的文本和图文记录,使检索、批量处理与模型训练能够采用同一套数字资源。[4][5]
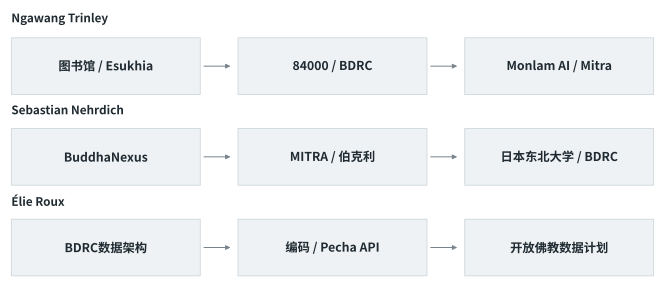
人员流动进一步把材料、工程和研究连接到持续交付。Ngawang Trinley从Sherabling图书馆和教学工作出发,共同创办藏语教育组织Esukhia,参与佛典翻译出版项目84000的典籍校订及BDRC数字化,随后参与Monlam AI/Mitra模型协作;Sebastian Nehrdich从BuddhaNexus互文平台开发进入MITRA翻译模型项目的技术和研究领导岗位,并于2025年赴日本东北大学(Tohoku University)任职。前者将文本校订、拼写和协作翻译经验带入数据与模型,后者将语言研究、检索和算法用于跨语种处理。专业经验因此能够跨项目积累,工具维护与资源更新也更依赖这些岗位的持续投入。[1][2]
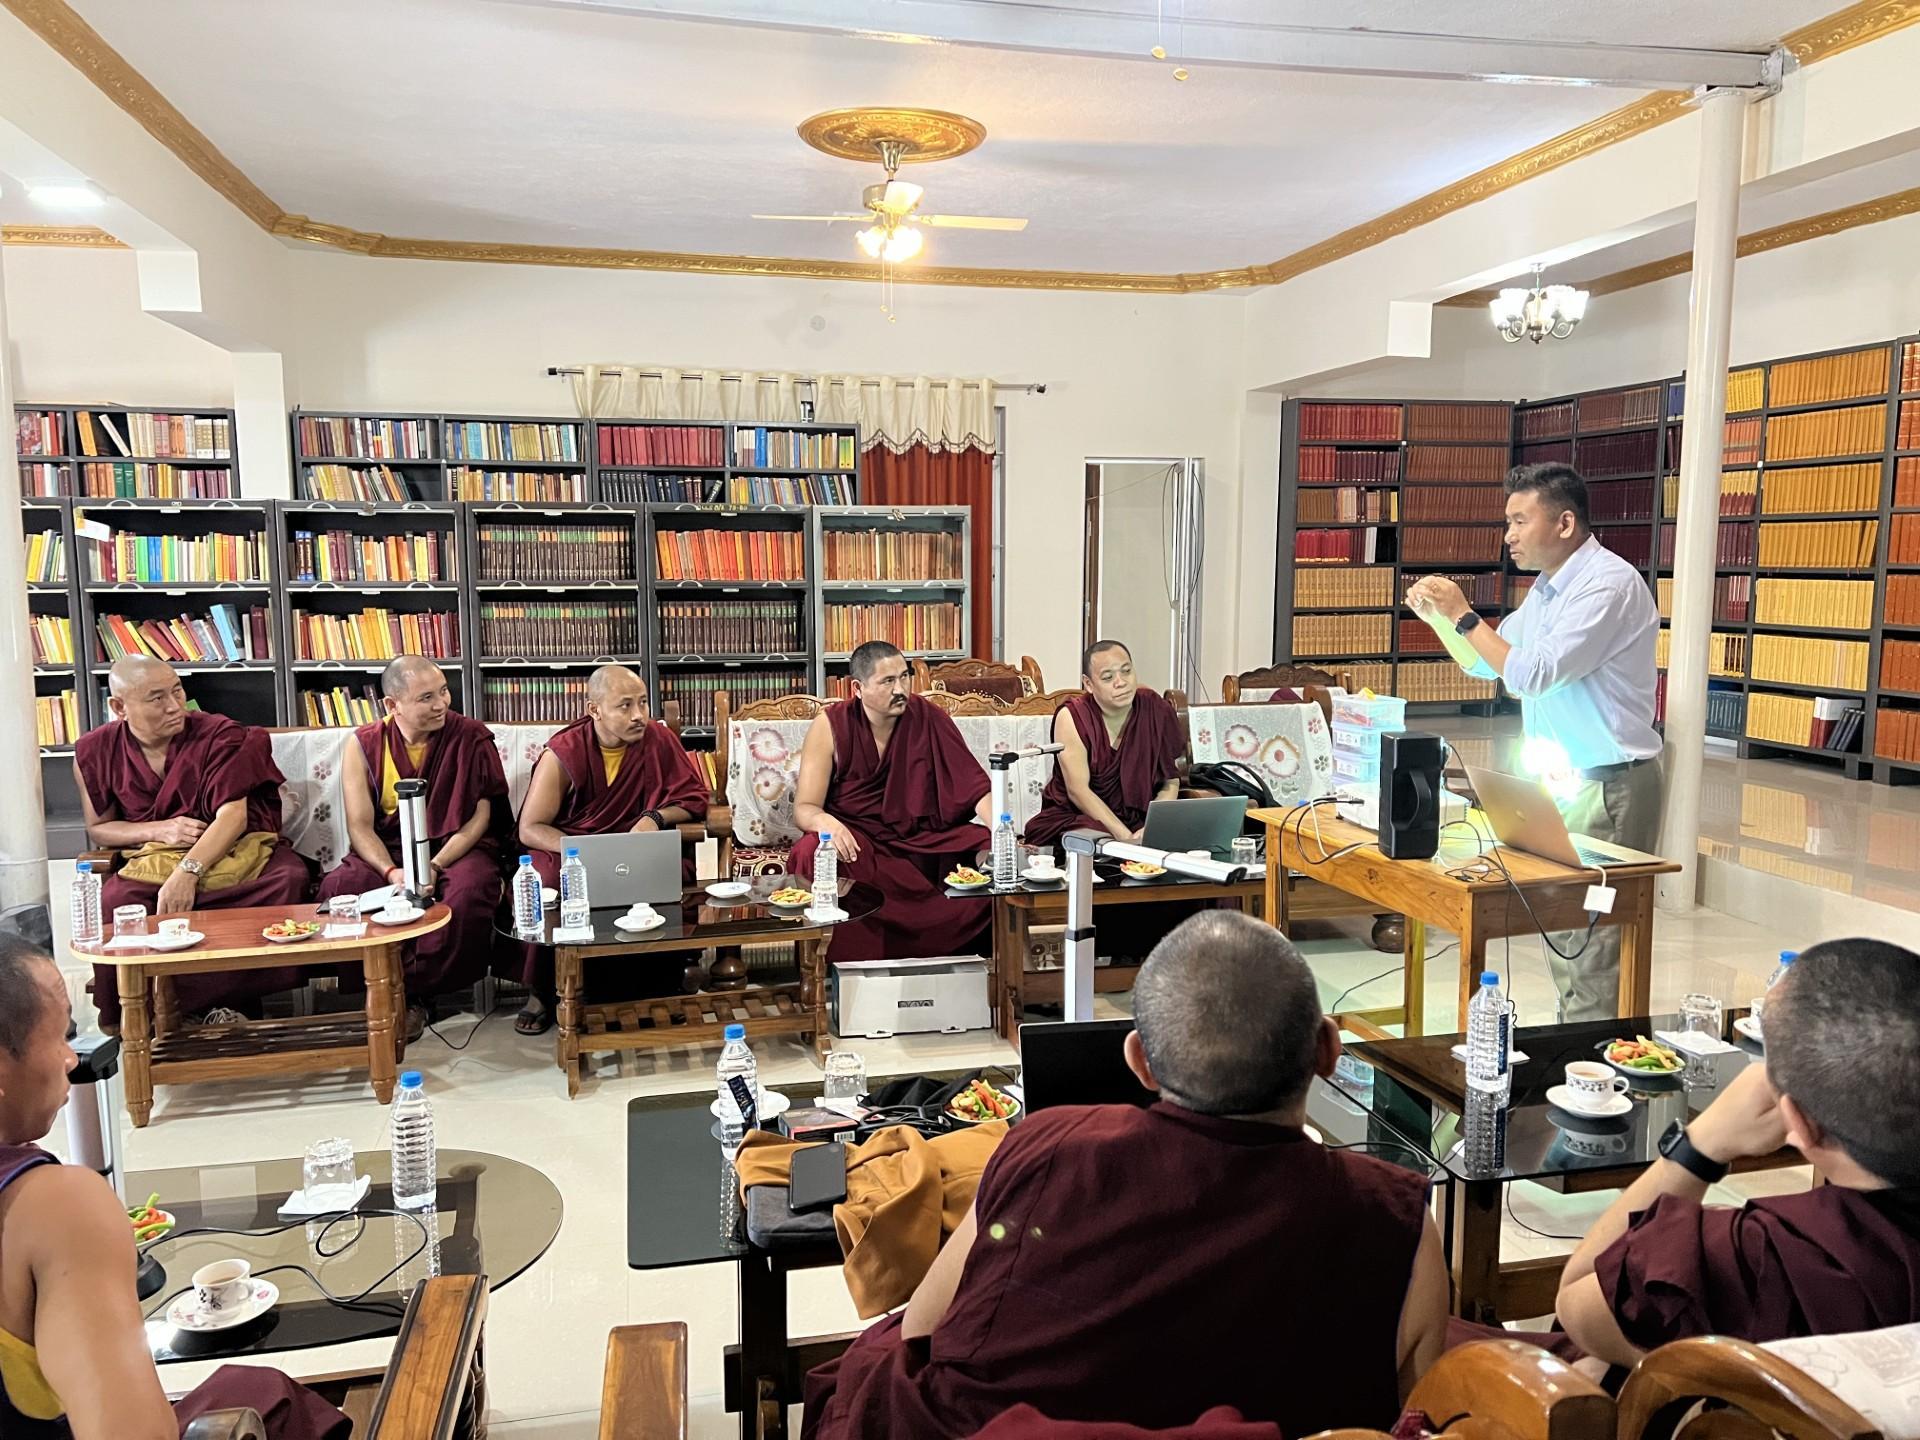
机构使用则把技术嵌入更稳定的工作流程。数字图书馆首年在20家宗教与文化机构开展培训,为2,000个书架和70,000部母本集成二维码;2026年3月的第三届联盟会议有54名代表,来自49家项目参与机构。目录、标识、扫描文件和工作人员的操作由此建立对应关系,资源组织方式进入文献入库、查找和日常维护。平台的影响也就从单次查询延伸至机构长期采用的分类、目录及操作规则,后续内容更新和系统转换都要衔接这些既有关系。[1][2]
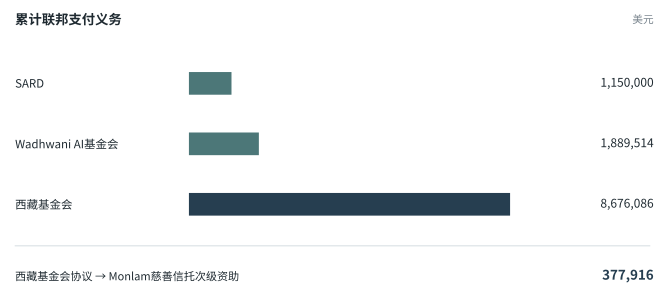
项目经费、基金会资助、私人支持和专业工时共同维持这条供给链。截至2026年10月23日,美国政府的三项相关合作协议分别由社会与资源发展基金、Wadhwani人工智能基金会和西藏基金会承接,累计联邦支付义务合计11,715,600美元,其中西藏基金会协议占74.06%;其项下Monlam慈善信托两笔次级资助报送合计377,916美元。资金沿协议、受款方和执行项目汇聚,再用于具体建设与人员安排。数字图书馆在资金短缺期间曾由私人资助者Alessia Bulgari承担一年员工工资,显示持续更新和用户支持需要后续经费接续。语言专家、工程人员、资料加工和日常维护共同决定服务能够持续提供的范围。[3][4]
主权话语风险在实际答案中已有可观察的表现。 题库POL-02的中文答复呈现不同的历史叙述起点:Melong依据所选文献,将西藏1912—1950年间的地位表述为“一个独立国家”;DeepSeek与豆包(Doubao)从中央管辖历史展开,Google的Gemini则按历史时期及主权概念组织回答。模型在给出答案的同时,把资料选择、概念界定和历史判断一并呈现给用户。当这种整合后的表述成为便捷的解释入口,特定主权解释可能以知识服务的形式反复出现,影响公众理解问题的起点和可见论据。[1]
技术成果也已进入明确的政治表达场景。2024年12月,美国国会及行政当局中国委员会(Congressional-Executive Commission on China,CECC)听证中,创办人洛桑门朗在回应叙事与人工智能问题时,谈及利用现代技术回应中国政府涉藏叙事,自述大语言模型相关资源汇集逾50,000部藏文书,并介绍在线翻译和Dalai Lama AI计划。2025年,国际声援西藏运动(International Campaign for Tibet,ICT)的颁奖活动又将223卷词典和人工智能工作列为授奖理由,同场包含涉藏政治发言。文化保存、技术创新和政治主张在这些活动中共同呈现,为主权议题的国际传播增加了表达材料与讨论入口。[1][2]
上述环节连在一起,形成了从知识供给到公众理解的连续路径:资料组织影响主权问题的叙述起点,生成答案和引文形式影响论据的可信外观,常用工具和机构业务延长使用,公开活动则将技术成果带入更广泛的议题讨论。应对的具体对象是可检索的原始资料、清晰的引文位置、准确的多语表达、公开的处理规则和稳定的维护能力。国内已有规模化平行语料、方言语音及覆盖多种训练任务的资源,可衔接史料整理、模型开发与公共知识服务。将这些能力落实到具体问题的资料对照、答案引用和版本更新,才能把长期话语能力建立在持续可用的知识与技术供给之上。[3][4]
实际问答与公开陈述呈现出五类风险:知识起点前置、引文可信度混同、规则默认化、跨语重复传播和国际议题联动。表1-1将具体事实与潜在影响对应。
表1-1 主权话语风险概览
| 风险 | 已记录的事实 | 对主权话语的潜在影响 |
|---|---|---|
| 知识起点前置 | Melong在POL-02答复中从特定史料引出“独立国家”判断 | 史料选择影响对西藏历史地位及中国主权依据的理解[1] |
| 引文可信度混同 | Melong有23/292条答复含引用占位标识,共76次 | 引文形式与出处缺口并存,增加史实与生成内容混同的风险[2] |
| 规则默认化 | BoBench以6,123道题及参考答案组织语法、文学和历史评测 | 选材、术语及参考答案可随产品采用成为默认表达[3] |
| 跨语重复传播 | Monlam门户2025年第四季度逾130万次请求、逾2.5万名用户 | 常用语言服务为主权相关内容提供持续触达入口[4] |
| 国际议题联动 | 创办人在美国国会及行政当局中国委员会听证中讨论以现代技术回应中国政府涉藏叙事 | 文化保存、技术成果与政治主张联结,扩大国际议题设置竞争[5] |
知识来源直接影响主权问题的回答起点。 POL-02中文题中,Monlam问答服务Melong依据所选历史文献,将西藏1912—1950年间的地位表述为“一个独立国家”;同题的DeepSeek与豆包(Doubao)答复从中央管辖历史展开,Google的Gemini则按历史时期及主权概念组织回答。[1]
自动化回答可使一种解释成为便捷的默认入口。 当用户直接使用检索、问答或翻译结果时,平台所选的史料和论述起点随答案一同呈现。
风险在于,带有特定立场的历史解释以知识服务的形式被持续调用,影响公众区分史实、作者观点和主权判断。
条款化叙述可能放大题干中的文书前提。 POL-06带有“1913年的《西藏—英国条约》”这一名称,Melong沿用该前提,扩展贸易、邮政及领事条款,并引出独立国家判断。英国外交部1920年《Tibet》手册则记载,西姆拉谈判始于1913年10月,草案于1914年4月草签。文书名称、时间和历史判断在答案中的组合,直接影响主权论据的呈现。[1][2]
引用样式与完整出处是两个具体的信息要素。 Melong的292条成功答复中,23条含“[None]”,占7.88%,共出现76次。主权相关答案若被继续转述,出处缺口和题干扩展也可能随之传播,增加事实辨识与纠正的成本。[3]
技术应用已被公开用于叙事表达。 2024年12月,美国国会及行政当局中国委员会(Congressional-Executive Commission on China,CECC)听证中,创办人格西洛桑门朗(Geshe Lobsang Monlam)在回应叙事与人工智能问题时,谈及利用现代技术回应中国政府涉藏叙事,自述大语言模型相关资源汇集逾50,000部藏文书,并介绍在线翻译及Dalai Lama AI计划。[4]
文化与技术成果增加了国际传播的表达材料。 涉藏倡议组织国际声援西藏运动(International Campaign for Tibet,ICT)的2025年颁奖活动将223卷词典和人工智能工作列为授奖理由,同场包含涉藏政治发言。由这些公开活动看,语言文化保存、技术创新和政治主张能够在同一传播场合相互关联,主权议题因而获得更多文化及技术叙述入口。[5]
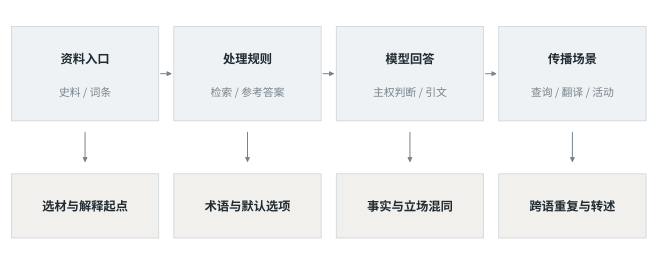
五类风险共同指向一个问题:公众从何处取得材料、采用何种术语、依据什么形成主权判断。技术生态通过知识与服务的持续供给参与这一过程。
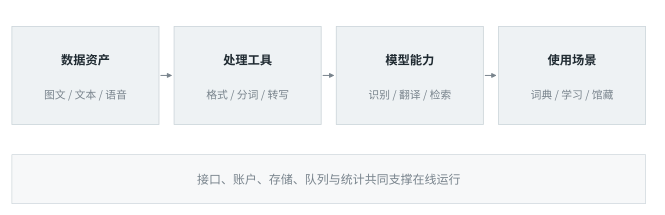
风险沿“材料选取—处理规则—模型答案—多语使用”传递。馆藏与语言人员提供基础材料,工具和模型形成可调用的结果,产品及机构应用把这些结果接入日常使用。
Monlam藏文信息技术研究中心(Monlam Tibetan IT Research Centre,Monlam ITRC)开展词典、语言技术和产品开发;藏人行政中央(Central Tibetan Administration,CTA)组织数字图书馆实施。资源机构、开发团队及高校研究者通过具体项目参与协作,分别提供材料、加工、模型和运营支持。[1][2]
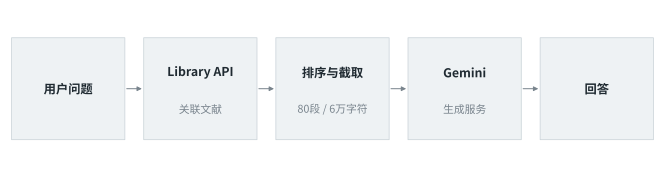
检索配置决定进入模型的材料组合。 WeBuddhist的分段问答读取文本资料接口,默认最多选取80个关联片段,单片段上限8,000字符,总量上限60,000字符;程序按来源类型排序,同类保持接口顺序,再依次截取。历史材料进入这类流程时,来源范围、排序和截取共同影响回答依据。[3]
跨机构人才承担知识与工具的接续。 Ngawang Trinley从图书馆、教学和Esukhia工作进入典籍校订、BDRC数字化及Monlam AI/Mitra协作;Sebastian Nehrdich连接互文平台、翻译模型和日本东北大学的研究岗位。人员流动使文本、模型与产品之间的联系持续运转。[1][2]
项目资金维持资源加工与服务运行。 社会与资源发展基金(Social and Resource Development Fund,SARD)、Wadhwani人工智能基金会及西藏基金会(The Tibet Fund)分别承接合作协议。基金会、专业工时和私人支持又补充研发与维护投入,持续供给能力因而与人员和资金安排相联系。[3][4][5][6][7]
文本、图文、语音和跨语资源形成配套。 公开资产同时服务材料保存、识别、翻译与检索;其中图文对齐和文本合集已经进入具体模型。
表1-2 核心数据资源
资源供给也在持续扩展。 BDRC开放数据计划安排将数百万页文献加工为数万份标准化电子文本,面向人工智能开发者发布。资源的规模化生产,使版本、选材和处理规则的影响随下游采用延伸。[8]
个人工具和机构系统形成不同的使用网络。 移动应用承担查询与表达,门户承担在线请求,学习平台连接活动与阅读,馆藏系统连接具体机构。
表1-3 主要使用记录
使用规模为内容持续触达提供实际入口。 当历史解释、术语和引文通过这些服务被查询、翻译或再创作时,主权相关内容可以跨平台和跨语言延续。内容来源及解释方式因此需要与用户服务一并治理。
资金按项目汇聚,并继续进入执行机构。 三项合作协议分别对应受款主体与实施任务,Monlam慈善信托获得主协议下的次级资助。
表1-4 项目投入概况(续)
建设投入和后续维护共同决定服务接续。 藏文批处理工具pybo的投入包括22,000美元启动资助、两名专业人员六个月的数据整理和训练材料支持。语言知识、工程维护及持续资金,都是资源长期更新所需的条件。[3]
主权话语能力建设应同时覆盖知识来源、回答依据和公共服务。优先形成可检索的原始资料、可追溯的多语答案及可持续的技术供给,使史料观点、文书事实与模型生成内容清楚对应。
表1-5 应对重点
将主权知识建设与实际服务连在一起。 应对重点从单次内容说明延伸到资料组织、默认规则、模型回答和跨语使用;完整史料、透明引文和稳定服务共同支撑长期话语能力。第二章展开生态资源与资金,第三章分析具体风险,第四章对应提出建设措施。
Esukhia 从教师培训和译者协作积累语言人员。 Esukhia 是开展藏语教育、翻译协作和数字资源建设的非营利组织。其机构沿革记载,2009 年开展 Bridge 译者与藏文教师结对项目,2011—2012 年开展在线藏语教学,并参照欧洲语言共同参考框架(Common European Framework of Reference for Languages,CEFR)探索能力分级;2013—2014 年培训约 60 名教师,2015—2017 年团队规模约为 60 人。[1]
兰炯耶谢学院(Rangjung Yeshe Institute,RYI)的会议简介记载,Ngawang Trinley 于 2009 年共同创办 Esukhia,参与 84000 所用德格《康珠尔》数字版校订,担任 BDRC 数字化项目经理,并参与 Monlam AI 及 Mitra 翻译模型项目工作。[1][2]
数字图书馆将相关技术接入机构工作流程。 藏人行政中央(Central Tibetan Administration,CTA)是设于达兰萨拉的流亡政治与行政机构,其宗教与文化部负责项目中的机构协调,人工智能机构 Wadhwani AI 与 Monlam ITRC 参与技术实施。2024 年项目首年公告记载,在 20 家宗教与文化机构开展培训,为 2,000 个书架和 70,000 部母本完成二维码集成。2026 年 3 月第三届联盟会议报道记载49家项目参与机构的54名代表参会。[1][2][3]
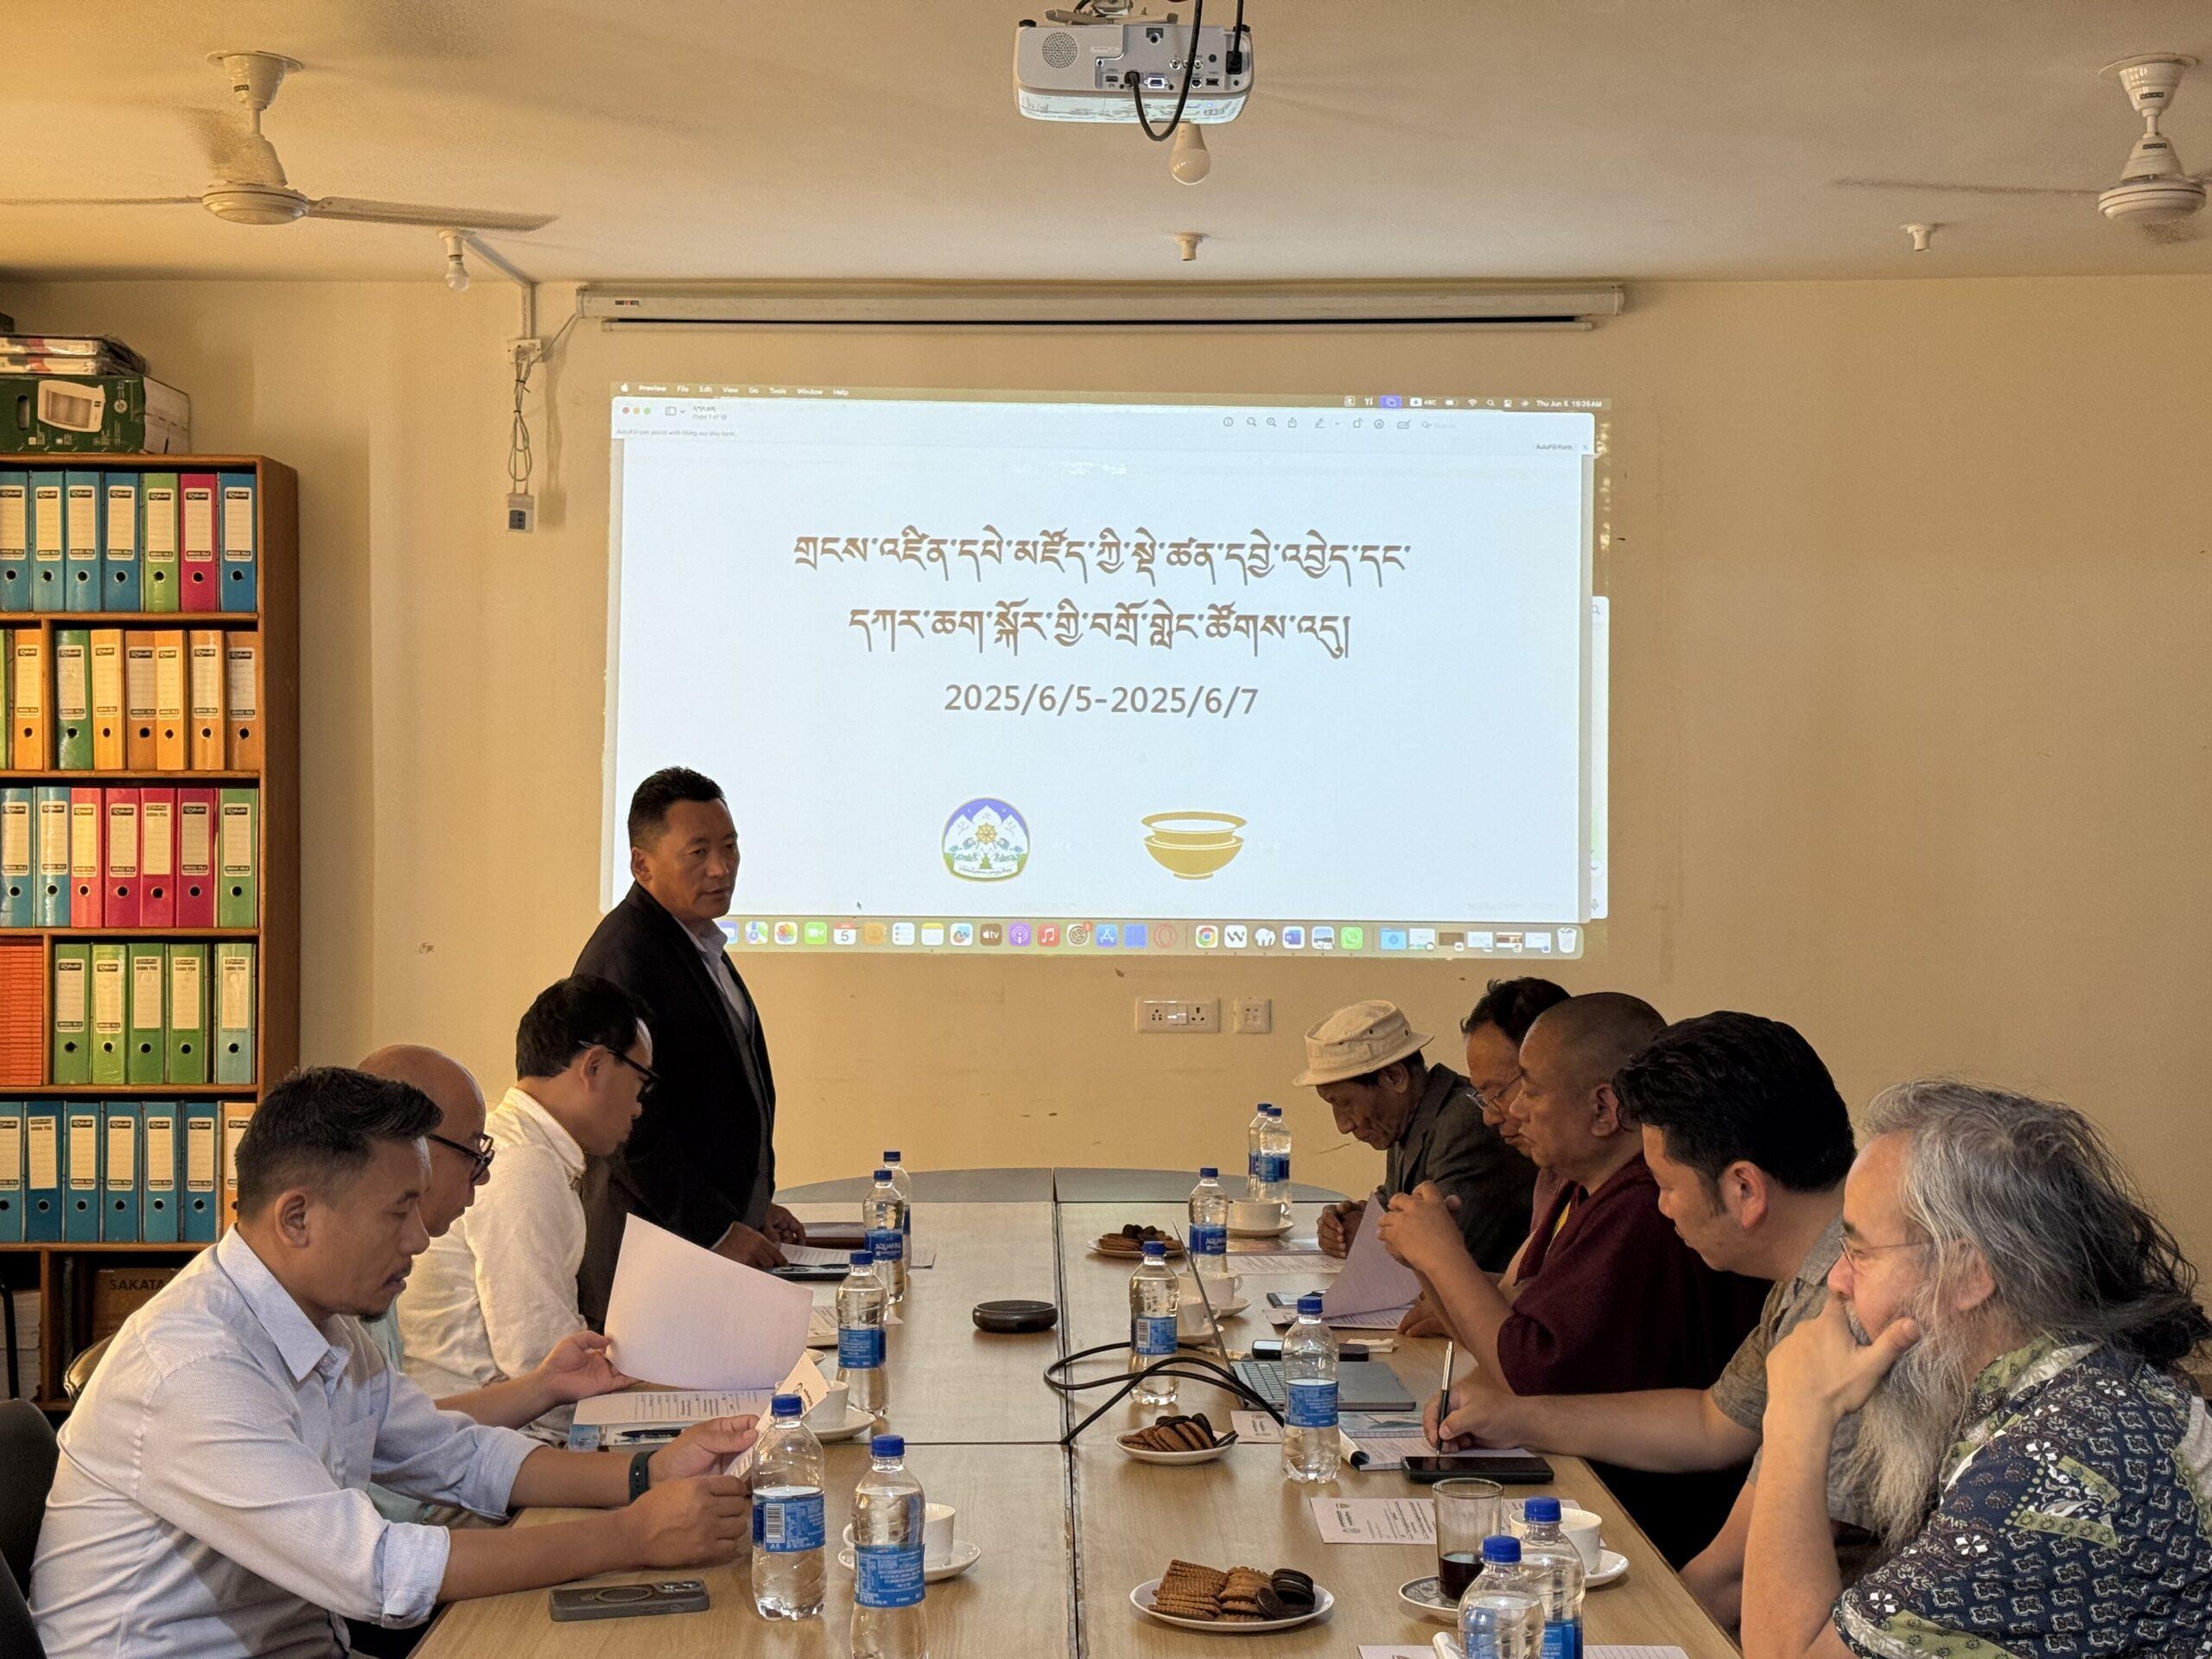
藏文图书馆管理系统(Tibetan Library Management System,TLMS)把目录、扫描、二维码和馆藏业务连接起来。2025 年 6 月,CTA 宗教与文化部与 Monlam ITRC 共同组织目录分类专家会议,审议由 Monlam 提出的框架。[4][5]
Melong.ai 在识别与翻译之外增加问答和推理功能。 2025 年 11 月 Monlam Manifestation 发布活动报道介绍了 Melong.ai 问答平台及其 Monlam Think 推理功能、Monlam Bodyig-4 字体和大词典应用。报道转述的机构内测结果包括约 1,500 道题的 73% 正确率、印度中央中等教育委员会(Central Board of Secondary Education,CBSE)12 年级藏文考试的 71% 得分;发布方同时介绍了约 13 万词元上下文和 140 种语言支持。[6]
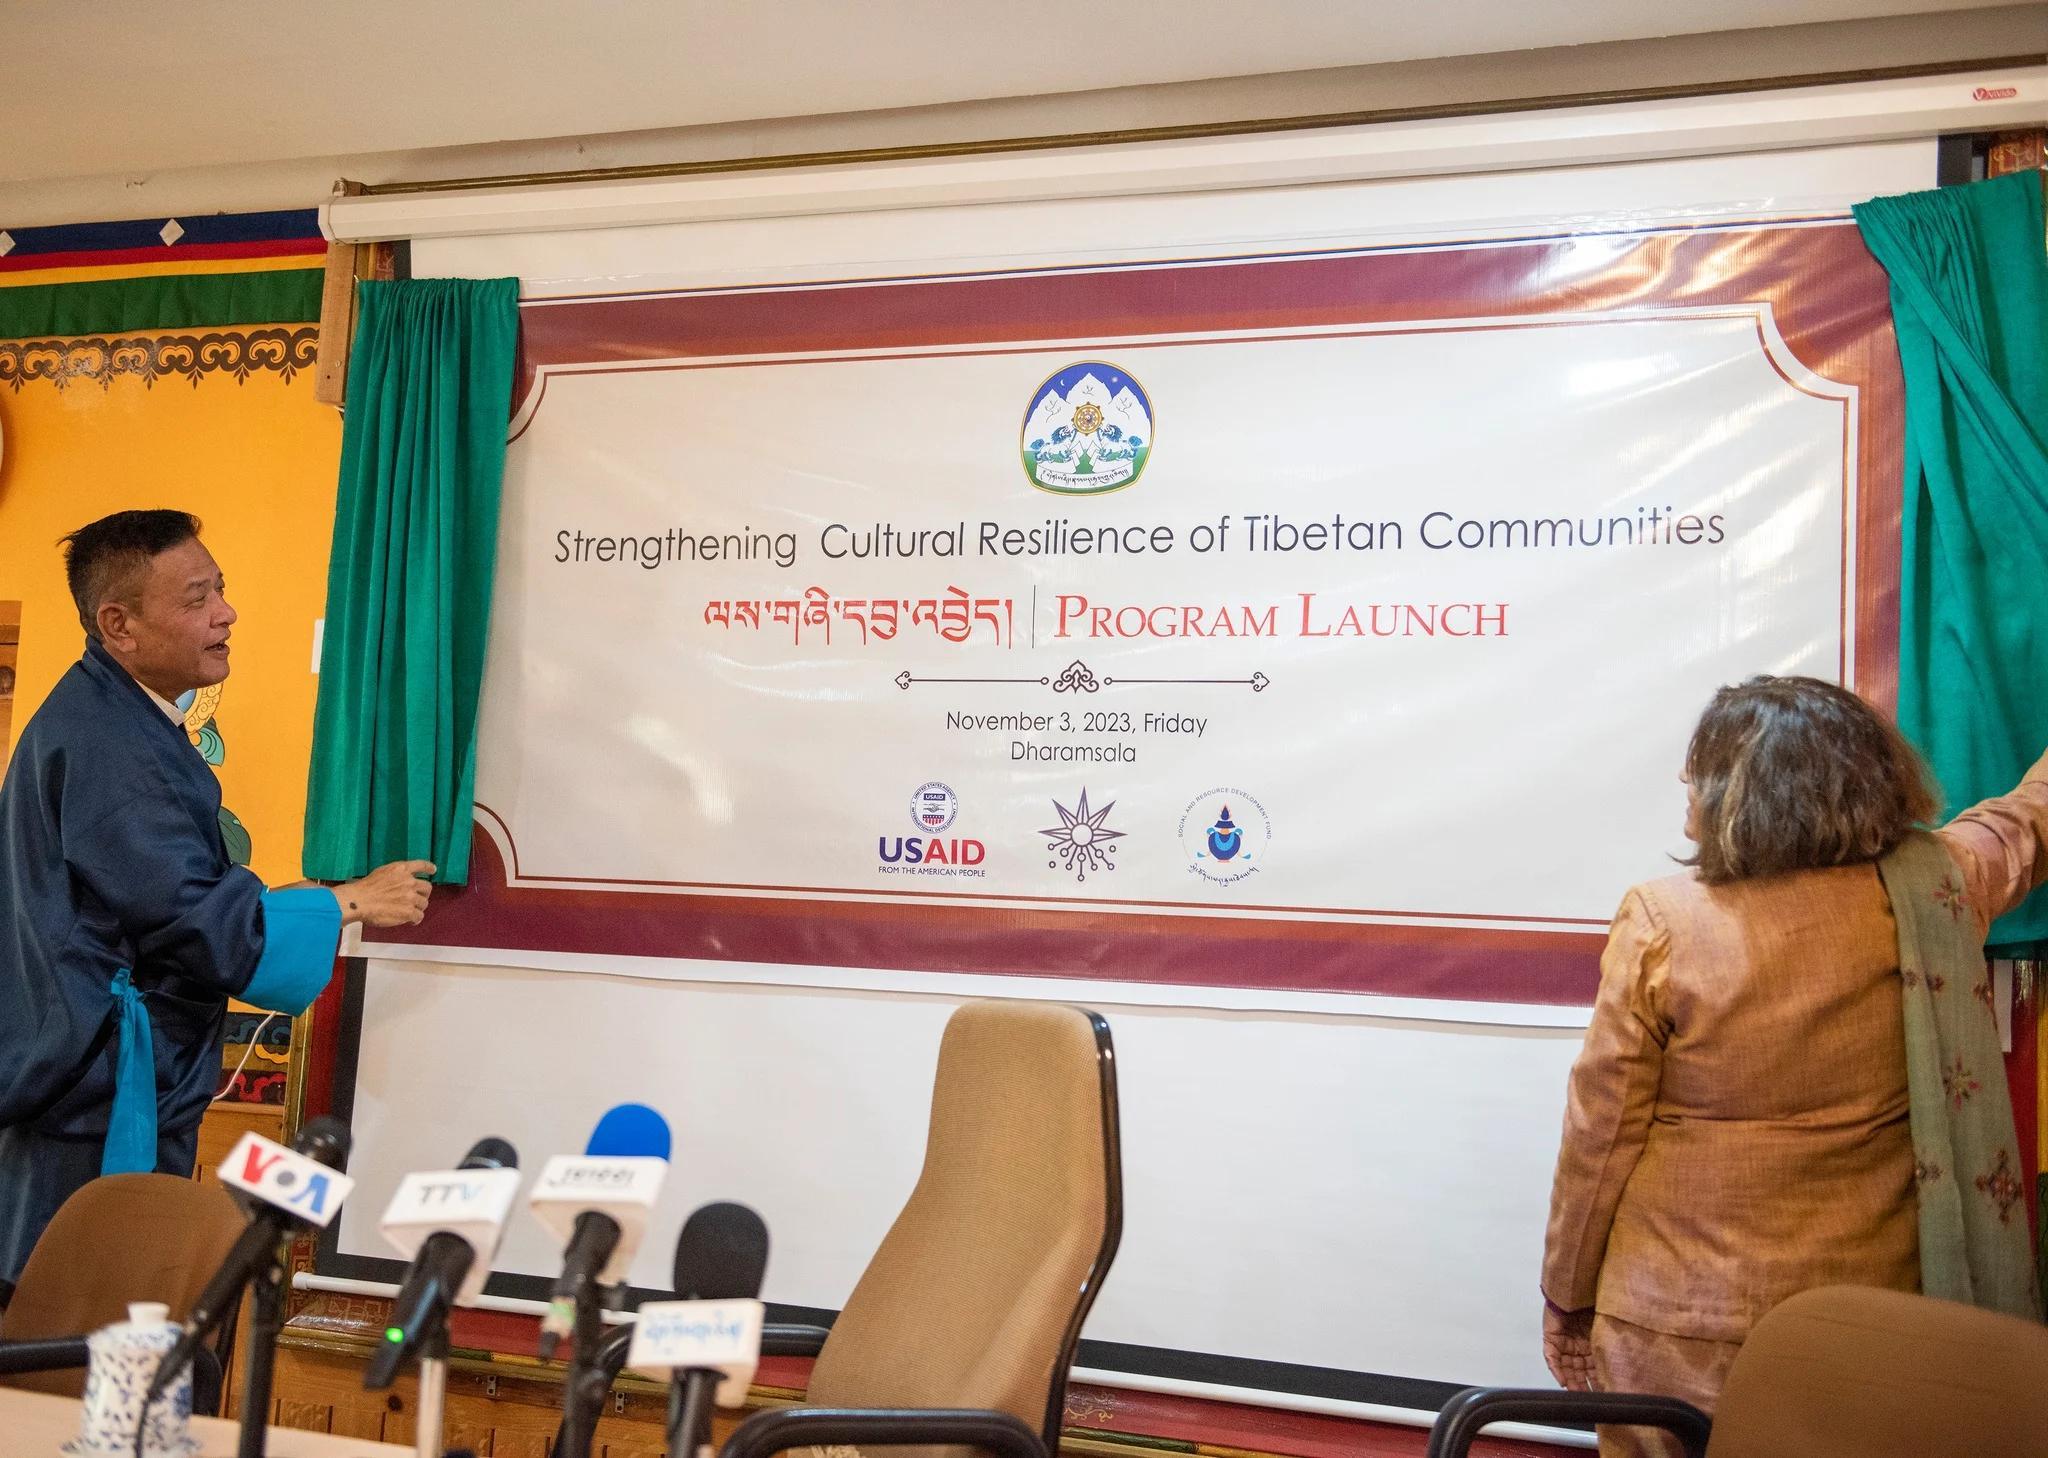
多年期项目为跨机构建设提供组织和资金框架。 美国国际开发署(United States Agency for International Development,USAID)资助的“增强藏人社区文化韧性”(Strengthening Cultural Resilience of Tibetan Communities)项目于 2023 年启动,为期三年,数字图书馆是其重要内容。西藏基金会 2024 年审计报告另列“南亚藏人社区自立与韧性计划”(Program for Self-Reliance and Resilience of Tibetan Communities in South Asia),协议编号 72038624CA00006,期限为 2024 年 10 月至 2029 年 9 月,协议金额 3,000 万美元。该协议于 2025 年 1 月 28 日暂停,同年 7 月 1 日获准恢复。[1][2][3]
公开资产已覆盖词典、图像转写和大规模文本三个层次。 2022 年发布的 Monlam 大词典为 223 卷,并衍生 37 个应用。截至2026年10月23日,MonlamAI 数据集 OCR-Dergetenjur 列有 845,118 条图像与转写记录;OpenPecha 发布的 BoCorpus 数据卡列有 8 类合集、1,039 条记录、603,325,999 个字符,约为 6.03 亿字符。[1][2][3][4]
后续计划继续扩大机器可读文本的生产规模。 BDRC 于 2026 年 2 月 28 日公告,获钦哲基金会支持的开放佛教数据集计划已于 2025 年 12 月启动,由技术负责人 Élie Roux 主持,资助安排延续至 2027 年夏。项目目标是将数百万页文献转为机器可读格式,形成数万份标准化电子文本,并面向人工智能开发者发布。[6][7]
典籍加工形成的专业知识,经格式和工具固化后进入模型与馆藏服务。扩展所依靠的核心资源因此包含文本、数据和跨机构人才,组织关系需要同时沿这三类要素观察。
资源、研发、受款与实施职责分属不同主体,跨机构人才将这些职能接到同一项目。馆藏方提供材料和规格,语言专家完成整理,开发者维护工具及接口,高校研究人员开发模型,资助与行政机构支持项目落地。
Dharmaduta把文本加工与软件开发组织到产品线。 Dharmaduta 对外展示 WeBuddhist、Sherab、Pecha AI Studio、Pecha Data & API 四条产品线,分别涉及佛典阅读与社区、在线教育、人工智能工具和数据接口。其团队介绍及数据集署名显示,文本整理和软件开发共同参与产品交付。公司页面提出将服务利润的 70% 回投社区、30% 用于持续经营。[1][2][3][4][5]
BDRC的2024年25周年机构说明记载,自1999年以来累计保存超过3,000万页佛教文献。[1]
BDRC/ALL-BDRC-alignments 数据卡记载 79,572 页对齐结果:亚洲传承图书馆(Asian Legacy Library,ALL)提供亚洲经典输入计划(Asian Classics Input Project,ACIP)的转写资源,结合 BDRC 等来源的扫描图像,由 Dharmaduta 完成对齐,并获钦哲基金会(Khyentse Foundation)支持。[2]
84000 与典籍项目提供内容和校订协作。 84000(Translating the Words of the Buddha)是佛典翻译与公开出版项目,其机构沿革记载,项目由钦哲基金会孵化,2013 年成为独立慈善组织。其与 Esukhia 的合作涉及《康珠尔》《丹珠尔》等典籍数字化,与高校的合作涉及译者培养、翻译研究和编辑工作。Barom/Esukhia 典籍项目在 pybo 藏文批处理工具的说明中被列为训练数据整理支持方。[3][4]
语言数据与科研能力互补。 Monlam 官网记载,Sebastian Nehrdich 在 Kurt Keutzer 指导下,于加州大学伯克利分校人工智能研究实验室(Berkeley Artificial Intelligence Research,BAIR)开展机器翻译研发,Monlam 提供数据。Dharmamitra 则是开展跨语种佛典语言技术研究的合作项目,其官网列出的合作方包括佛学研究与翻译支持机构 Tsadra Foundation、日本东北大学综合日本学研究中心(Center for Integrated Japanese Studies,CIJS)及伯克利 BAIR。[5][6][7]
该团队的 MITRA 研究论文报告,梵—藏、汉—藏、梵—汉三个语言对共形成 1,742,786 组自动挖掘的平行句对,并开发机器翻译模型 MITRA-MT 和语义嵌入模型 MITRA-E。[8]
人才联系沿三条具体路径展开:教学与校订人员进入数字化和模型协作,高校研究人员连接互文检索与机器翻译,开发者跨项目承担词典、数据接口和终端应用工作。Nehrdich从BuddhaNexus开发转入MITRA领导及东北大学任职,TenzDelek从MonlamAI进入Webuddhist-tech;BDRC的负责人接续又把学术研究、馆藏数据和项目治理联系起来。[1][2][3][4][5]
表2-1 核心人才的机构经历、项目角色与成果联系
| 人员 | 早期机构与专业经历 | 后续重要角色 | 连接的平台、数据或工具及作用 |
|---|---|---|---|
| Ngawang Trinley | Sherabling图书馆及教学;2009年共同创办Esukhia;84000德格《康珠尔》数字版校订 | Esukhia印度分支负责人、董事;BDRC数字化项目经理;Monlam AI/Mitra协作者 | 把扫描、校订、拼写和协作翻译经验用于文本加工、译者培养和模型材料准备[6][1] |
| Sebastian Nehrdich | 汉堡大学语言与佛学训练;2018年起开发BuddhaNexus;伯克利BAIR合作 | 2023年起参与MITRA,先任CTO、后任主任;2025年10月1日加入东北大学CIJS,11月加入BDRC董事会 | 将互文数据库、跨语检索、平行句挖掘和OCR用于Dharmamitra;2026年MITRA-lexicon形成六方向词典资源[7][2][8][5] |
表2-1 核心人才的机构经历、项目角色与成果联系(续)
| 人员 | 早期机构与专业经历 | 后续重要角色 | 连接的平台、数据或工具及作用 |
|---|---|---|---|
| Kurt Keutzer | 伯克利BAIR的人工智能研究与机器翻译指导 | Dharmamitra共同创办人、战略顾问;MITRA论文作者 | 提供算法、模型训练与研究组织支持,连接高校研究和佛典翻译应用[1][2][3][4] |
| Élie Roux | 自2017年在BDRC设计软件与数据架构 | 2021年钦哲愿景项目顾问;2026年开放数据计划负责人;Pecha API工作组BDRC成员 | 连接馆藏元数据、关联开放数据、文本编码、自动音译和语言工具,推动文献转为机器可读资源[5][6] |
| Jann Ronis | 2006年在TBRC参与书目提纲;后在伯克利任教 | 2018年接任BDRC执行主任 | 早期目录工作进入馆藏元数据模板,任内推进BUDA及跨机构数字档案访问[7] |
表2-1 核心人才的机构经历、项目角色与成果联系(续)
| 人员 | 早期机构与专业经历 | 后续重要角色 | 连接的平台、数据或工具及作用 |
|---|---|---|---|
| Gregory Forgues | 维也纳大学博士、莱顿大学Open Philology研究;84000等机构的领导或治理工作 | 2026年5月获任BDRC执行主任;Dharmamitra顾问 | 将语文学、翻译机构和数字研究经验接入资源机构治理及人工智能工具合作[1][2] |
| Gedun Rabsal | 瓦拉纳西藏学研究;2002年起在印第安纳大学教授藏语文学 | 2026年6月当选BDRC董事会主席 | 把文学史、翻译与编辑经验用于馆藏机构的学术方向和合作网络[3] |
| TenzDelek | 公开履历列此前任职MonlamAI;2024年提出大词典编辑器设计 | Webuddhist-tech软件工程师(SDE 2) | 连接Monlam词条编辑、查询与用户角色设计,以及后续平台开发[4] |
| Ju Tenkyon | Monlam大词典框架主编 | BoBench文学领域专家 | 将词典与文学知识用于题目、参考答案及专业评价内容[5][6] |
| Tenzin Rabten | Dharmaduta佛教数据专业岗位与联合创始团队 | ALL-BDRC图文对齐项目的手稿识别贡献者 | 把文本知识用于扫描图像识别和对齐,参与79,572页图文资源生产[7][8][9] |
寺院图书馆和教学经历形成文本组织基础。 Ngawang Trinley在印度学习藏语及相关学科后,负责Sherabling的College of Buddhist Sciences图书馆,并承担藏语和相关课程教学。2009年共同创办Esukhia后,继续担任印度分支负责人和董事,工作涉及语言教学、翻译、转写与项目组织。[1]
84000与BDRC把校订经验接入馆藏资源。 他参与84000所用德格《康珠尔》数字版的校对和编辑,后在BDRC担任数字化项目经理,负责扫描件与电子文本以及用户、合作机构关系。其开发和组织的工具包括实时在线协作翻译、校对软件及藏文拼写检查,分别服务译者协作、文本修订和语言规范化。[2][1]
译者课程与模型合作继续使用同一套专业经验。 RYI讲者资料介绍,Kumarajiva Project将其沉浸式藏语课程用于译者培养;相关报告还介绍他参与Monlam AI/Mitra机器翻译和佛教大语言模型工作。[1]
数据成果把人员联系转为可使用的资源。 MITRA研究形成1,742,786组多语平行句对,用于翻译和语义模型;2026年10月发布的MITRA-lexicon进一步组织梵英、梵藏和梵汉六方向词典,合计218万词头条目及1,040万条引用例证,每条例证连接平行句对和字符位置。2025年11月Nehrdich加入BDRC董事会,馆藏资源与模型研究又增加了治理层的联系。[1][2][3][4]
BDRC的技术岗位连接数字馆藏与外部合作。 Roux自2017年起在BDRC设计软件和数据架构,并管理与学术机构、传统文献机构和馆藏的合作。其专业工作涉及关联开放数据、文本表示和藏文自然语言处理,已有藏文拼写检查、动词检查及文本编码工具。[5]
创办人和早期目录人员奠定馆藏组织方法。 E. Gene Smith(1936—2010)于1999年创办TBRC。Jann Ronis于2006年以驻馆研究人员身份与Smith合作,参与早期书目提纲编制;该提纲后来成为BDRC元数据的重要模板。Ronis随后在伯克利东亚语言与文化系任教,2018年7月15日转任BDRC执行主任,接替在该机构服务17年的Jeff Wallman。[4][5]
数字档案平台成为学术与馆藏之间的共同入口。 Ronis任内推出Buddhist Digital Archives(BUDA),扩展检索与合作机构资料连接。BDRC沿革记载,BUDA于2021年上线,采用关联开放数据组织馆藏,使扫描件、目录和相关文献可通过同一平台检索。[5]
2026年的治理调整引入翻译、语文学和文学史经验。 5月18日获任执行主任的Gregory Forgues拥有维也纳大学博士和莱顿大学Open Philology项目研究经历,并曾在84000、钦哲基金会、Siddhartha’s Intent及Tsadra Foundation承担领导或治理工作;Dharmamitra也将其列为顾问。6月25日当选董事会主席的Gedun Rabsal曾在隆务寺、甘丹绛孜学院及瓦拉纳西藏学机构学习研究,2002年起在印第安纳大学伯明顿分校教授藏语文学,并从事文学史、翻译和期刊编辑。[1][2][3]
文本专业组负责把文献知识转为数据内容。 官网将Tenzin Rabten、Tsering和Gade列为三名佛教数据专业联合创始人。ALL-BDRC-alignments的署名将Tenzin Rabten列入手稿识别人员,将Gade列入逐页对齐人员;该项目以ACIP转写和馆藏扫描形成79,572页图文对齐资源,由Dharmaduta加工、BDRC提供规格、钦哲基金会支持。[4][5]
执行团队继续按产品配置开发者和文本人员。 2026年10月23日团队页面列43条人员记录:运营5条、WeBuddhist17条、Sherab2条、Pecha AI Studio8条、Pecha Data & API11条。WeBuddhist组含6个软件开发岗位和11个文本专业岗位,文本知识与软件实现被放入同一工作组。[1]
TenzDelek的任职变化伴随词典产品开发。 其公开履历列此前任职MonlamAI,现为Webuddhist-tech软件工程师SDE 2。2024年12月17日,他在OpenPecha项目中提出Monlam大词典编辑器设计,任务包括词条修改、查询和用户角色管理;kaldan007参与该议题的评阅。[2]
Pecha API工作组把多个机构与产品的人员放在同一接口任务中。 Tashi Tsering的GitHub资料列Esukhia,其账号ta4tsering与工作组开发岗位对应,工作组主席栏也列其姓名;Tenzin Kunsang的账号tenkus47列Webuddhist、Dharmaduta、OpenPecha和Monlam,工作组中对应Pecha AI Studio。成员表另列Gabor Detari为负责人、Tenzin Tsering为开发者、Élie Roux代表BDRC、Tenzin Samten对应WeBuddhist、Tenzin Tsewang对应Pecha Data,项目共同连接Pecha API、Toolkit V2与STAM。[3][4]
教学活动为开发和标注培养人员。 2025年1月31日Sarah College活动共有21名参与者,课程涉及人工智能、文本与图像标注;2月2日DLIHE活动有28人,包括17名学生、3名教师和8名Monlam讲师及组织者,课程包括代码可读性、版本控制及真实项目协作。DLIHE同年2月院刊记载了该项软件工程实训。青年项目还提供奖学金、职业认证、导师和实习安排。[1][2][3][4][5]
财务岗位也在公益机构之间流动。 Manjushri Educational Services的职业简介记载,Tenzin Lhazey于2025年4月加入,担任办公室行政与会计;此前在Monlam Charitable Trust与Bir Tibetan Society合计约五年的经历覆盖记账、审计、财务规划、收支分析,以及商品与服务税(GST)和源头扣税(TDS)申报。[6]
Wadhwani AI以人工智能研发和平台实施承接文献数字化项目。 机构由Romesh Wadhwani与Sunil Wadhwani创办,2018年启动;2026年10月官网列Shekar Sivasubramanian为机构负责人,Alpan Raval为人工智能与机器学习首席科学家。数字图书馆项目由Wadhwani AI承担主要技术工作,与Monlam ITRC协作开发数字资源库;2023年合作协议的受款方为Wadhwani Institute for Artificial Intelligence Foundation。[2][1][3]
SARD 承担发展援助和项目协调。 社会与资源发展基金(Social and Resource Development Fund,SARD)官网记载,该组织由 CTA 于 1997 年建立,参与发展援助及项目组织,公布的外国捐款许可编号为 182450041;截至2026年10月23日,该机构人员页面列 Lobsang Tenzin 为主任。[4]
西藏基金会与钦哲基金会将资金投入不同建设环节。 西藏基金会(The Tibet Fund)是美国非营利机构,EIN 为 13-3115145。其年报记录对 Monlam 语言资源、人工智能及发布活动的支持,审计和税务资料列示项目资助与拨付安排。钦哲基金会 EIN 为 91-2167303,其支持涉及 pybo、84000 和 BDRC 开放数据计划。[1][2][3][4][5]
西藏基金会的治理与项目管理支持资金转拨。 2023年度Form 990列Robert Ankerson为主要负责人,治理机构有11名有表决权且独立的成员、5名员工和约11名志愿者;相关赠款经管理层审查、董事会预算批准及书面协议进入项目执行。[1][2]
两个Monlam产品保留了OpenPecha的代码来源联系。 MonlamAI的monlamai-app-web及MonlamGrandDictionaryEditor项目说明含OpenPecha标识或代码克隆路径。[3][4][5]
跨机构协作通过具体岗位、接口和资助任务落实:同一人员能把馆藏经验带入模型,同一工具能服务多个产品,同一项目能汇聚多方投入。平台和产品的实际能力,取决于这些联系最终形成的资源及可持续服务。
技术链由数据、加工规则、模型、后台和应用组成,表2-2归并35项技术与运营对象。公开数据的价值通过训练采用体现,工具能力通过接口和用户产品体现,个人应用与机构馆藏又形成不同的运行场景。
表2-2 技术链分工:八类职能覆盖35项技术与运营对象(续)
| 层次 | 主要对象 | 主要作用 |
|---|---|---|
| 结构化与加工规则(7项) | OPF;Toolkit/编辑器 | 组织文本版本、标注和数据交换[1] |
| 结构化与加工规则(续) | Botok;pybo;pyewts/dakje | 分词、批处理、转写与书写辅助[2] |
| 结构化与加工规则(续) | Pydurma/校勘工具;自然语言处理(Natural Language Processing,NLP)及对齐工具群 | 校勘、异文处理与文本对齐[3] |
| 词典与字形(3项) | Monlam大词典;词典编辑器;字体资产 | 提供释义、编辑和字符显示资源[4][5][6] |
| 模型、评测与智能交互(5项) | Monlam Melong;Bo-Eval | 提供问答、推理及知识与语音评测[7][8][9] |
表2-2 技术链分工:八类职能覆盖35项技术与运营对象(续)
表2-2 技术链分工:八类职能覆盖35项技术与运营对象(续)
| 层次 | 主要对象 | 主要作用 |
|---|---|---|
| 用户与机构应用(6项) | Monlam AI Tools Web;Monlam Keyboard;WeBuddhist Web/App | 面向个人提供语言工具、输入与阅读[1][2][3][4] |
| 用户与机构应用(续) | Sherab/WB Academy;数字图书馆/TLMS;Digital Kangyur数字典籍浏览项目 | 连接学习、馆藏与典籍访问[4][5][6] |
| 跨层运营(4项) | Buddhist AI Tools资源创作套件;Dharmaduta产品平台 | 组织工具、资源和产品开发[7][8] |
| 跨层运营(续) | 佛教创作者大会;Monlam慈善信托活动后台 | 连接内容创作、培训和项目组织[9][10] |
文献、语音和多语种文本共同构成训练材料基础。 佛教数字资源中心(Buddhist Digital Resource Center,BDRC)提供扫描、目录和电子文本等资源;Esukhia 积累典籍数字化与语言教育材料;MonlamAI 和 OpenPecha 通过代码及数据平台组织加工和发布。Esukhia 的德格版《康珠尔》《丹珠尔》数字文本连接早期典籍建设与后续校勘,图像转写和语音数据又将资源供给扩展至多模态处理。[1][2]
表2-3 主要数据资产的类型、规模与训练及公开供给作用
| 资源类型与资产 | 规模及期间 | 公开供给形式 | 已记录的训练采用或评测作用 |
|---|---|---|---|
| 图像转写:OCR-Dergetenjur | 2026年10月23日平台列845,118条图像与转写记录 | MonlamAI数据集页面提供记录与数据文件 | 德格《丹珠尔》图像与转写形成文字识别及文本处理材料[3] |
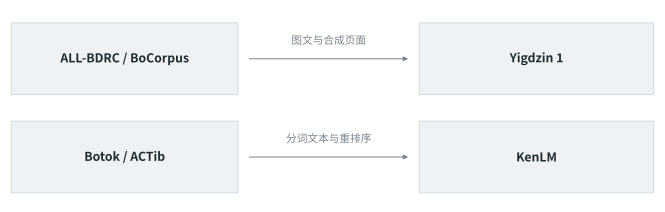
| 图文对齐:ALL-BDRC-alignments | 79,572页对齐结果 | 数据卡列扫描、转写、加工方和公开资源入口 | Yigdzin 1训练说明将其列为图文输入资源[4][5] |
| 文本合集:BoCorpus | 8类合集、1,039条记录、603,325,999字符,约6.03亿字符 | 按BDRC规格形成标准化文本合集,由Dharmaduta加工并公开发布 | Yigdzin 1使用其文本生成合成页面,将纯文本转为OCR训练输入[6][5] |
| 语音及转写:stt-training-data | 2024年10月18日采集概览:1,391,020个文件、1,576.76小时、8类场景;公开分集:训练1,362,015条、验证20,742条,合计1,382,757条 | 公开音频、转写、类别与时长等字段,按训练和验证划分发布 | 为语音识别开发提供可获取的音频—文本材料及验证划分[7] |
表2-3 主要数据资产的类型、规模与训练及公开供给作用(续)
| 资源类型与资产 | 规模及期间 | 公开供给形式 | 已记录的训练采用或评测作用 |
|---|---|---|---|
| 多语平行语料:MITRA | 梵—藏、汉—藏及梵—汉合计1,742,786组自动挖掘句对 | 论文、代码和数据入口共同提供语言对及加工方法 | 形成MITRA-MT机器翻译模型和MITRA-E语义嵌入模型,服务跨语种翻译与检索[1] |
| 分词训练文本:ACTib | 17,731,410行文本 | 同一底层语料提供未分词与定制Botok分词版本 | 用于字符五元KenLM训练和规范化候选重排序,分词工具经数据加工进入下游模型[2] |
| 知识评测:BoBench | 6,123道选择题 | 提供题目、选项、参考答案及专家说明 | 用于藏文语法、文学和历史知识评测,为模型比较提供固定任务[3] |
| 语音评测:Bo-voice | 8,367组音频与转写、8类场景 | 公开音频与转写分集 | 用于多场景语音识别评测,与训练数据共同构成开发及测试资源[4] |
加工机构将上游资源组织为可重复使用的数据产品。 BoCorpus 数据卡记载,Dharmaduta 按 BDRC 规格制作语料,钦哲基金会(Khyentse Foundation)提供支持;ALL-BDRC-alignments 将 BDRC 等来源的图像、亚洲传承图书馆(Asian Legacy Library,ALL)提供的转写资源和 Dharmaduta 的对齐加工结合起来。[1][2]
代码与数据平台为分散生产和公开分发提供组织条件。 2026 年 10 月 23 日组织页面显示,MonlamAI 有 4,297 个公开仓库,Webuddhist-tech(原 OpenPecha 组织)有 555 个,Esukhia 有 115 个,合计 4,967 个。仓库中包含数据分片、加工脚本、模型服务和应用项目;Hugging Face 则集中提供模型文件、数据集和演示服务。[3][4]
图像识别将典籍页面转化为可计算文本。 光学字符识别(Optical Character Recognition,OCR)工具群覆盖图像预处理、版面切分、字符识别和转写输出,TibetanOCR_PyTorch、OCR-Pipelines等项目组织相关工序。[5]
版面标注把原图、掩码和部分文献来源连接起来。 数据集列有43,251条记录,其中6,260条填写了28个不同BDRC作品编号,并列原图和掩码链接,支持版面分析与来源对应。[1]
Yigdzin 1模型卡列明训练资源和识别测试结果。 BDRC 的 Yigdzin 1 藏文 OCR 模型约有 8 亿参数,基于 PaddleOCR-VL-1.6,数据说明列有 ALL-BDRC 图文对齐资源及 BoCorpus 合成页面。发布方在 1,070 页基准上的测试报告显示,逐页字符错误率的平均值为 6.28%,中位数为 1.42%。[2]
第二代工具将文本处理与云端存储连接起来。 2025 年 10 月 29 日发布的 openpecha 2.5.0 采用独立式文本标注模型(Stand-off Text Annotation Model,STAM),将正文和标注分离,项目说明使用 Firebase 作为存储与访问后端,并提供序列化、导出等能力。[1]
词典编辑器维护词条,字体集合与预览工具服务文字显示。 2022 年 Monlam 大词典发布记录列有 223 卷、200 余名参与者、九年建设及 37 个应用;词典编辑器连接账户、数据库和接口服务。Monlam 字体及 OpenPecha 字体集合支持网页、文档与移动端显示,Monlam Font Viewer 提供字体预览入口。[2][3][4]
分词与语言工具将处理规则嵌入下游数据流程。 Botok 处理词边界、词元、词性和规范化词形,pybo 提供排序与批处理,pyewts 支持 Unicode 与扩展 Wylie 转写转换,dakje 提供书写辅助;Esukhia 的 bophono、sympound-python 等项目分别处理音系转写和拼写建议。[5]
PaganTibet 的 ACTib 语言模型数据页面列有 17,731,410 行文本,项目说明介绍了采用定制 Botok 的处理版本,并将相关数据用于字符五元 KenLM 训练和文本规范化候选重排序。[6]
生成式问答和检索增强服务扩大内容组织方式。 2025 年产品发布报道介绍 Melong.ai 问答平台及其 Monlam Think 推理功能,并转述约 13 万词元上下文、140 种语言和图文输入能力。buddhist-consensus 项目的当前说明以 Webuddhist AI 为名,采用检索增强生成(Retrieval-Augmented Generation,RAG),支持混合、关键词、语义和精确匹配四类检索,使用 Milvus 保存向量索引、LangGraph 组织处理流程,并接入 Gemini 生成服务。[1][2][3][4]
平行语料进一步形成可查询的跨语词典。 2026年10月19日发布的MITRA-lexicon研究由Nehrdich等提出,覆盖梵英、梵藏和梵汉六方向词典,合计218万词头条目及1,040万条引用例证;例证连接句对、词语及译词的字符位置,并提供网页查询入口。[5]
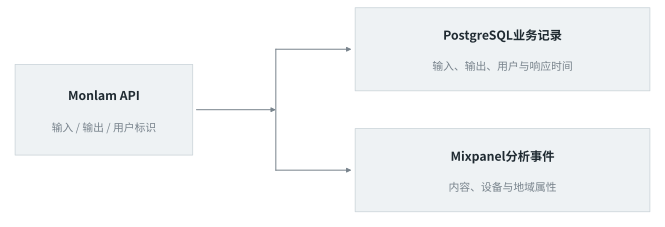
Monlam 的网页和接口项目汇集多模态任务。 应用程序接口(Application Programming Interface,API)用于连接客户端与后台服务。monlamai-app-web 项目说明列出 Auth0 身份认证、PostgreSQL 数据库、AWS S3 对象存储及模型接口配置;monlamai-API 采用 FastAPI,组织翻译、OCR、聊天、用户和文件相关功能。[1][2]
数据接口与助手后端承担不同的服务任务。 OpenPecha-API提供文本数据接口,PechaAPI是另一个使用FastAPI的服务端仓库;Dharmaduta的Pecha Data & API为文本接口产品线。Assistant-Agent提供助手应用后台,pecha.tools的藏英译后编辑工具组合Dharma Mitra、ChatGPT和Bing Translate接口。[3][4][5][6]
内容平台通过专门后台组织音频和用户任务。 WeBuddhist 后端处理内容及业务接口;webuddhist-worker 当前说明通过 HTTP API 访问主后端内容和计划,使用独立 PostgreSQL 保存提醒与通知,使用Amazon简单队列服务(Simple Queue Service,SQS)排列音频及通知任务,Redis 提供幂等与缓存支持。[7]
Matomo封装支持页面、搜索、下载和外链事件统计。 Matomo Tracker 的 React 封装说明列有页面访问、事件、站内搜索、下载和外链统计,并提供用户标识、心跳及同意配置。[8]
同一卖方的10款应用覆盖三类主要用途。 截至2026年10月23日,Apple美国区应用商店列有Lobsang Monlam名下的6款词典、3款语言工具和1款文化导览应用。首次发布日期跨越2016—2026年,4款应用的版本更新日期集中于2026年10月。[1]
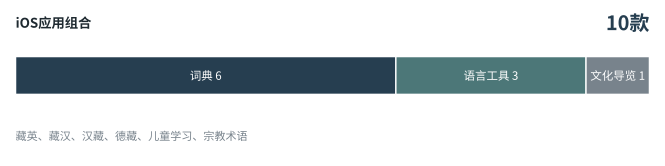
表2-4 Lobsang Monlam名下10款移动应用(Apple美国区,截至2026年10月23日)
| 应用及分述 | 主要功能与资源 | 首次发布日期 | 版本/更新日期 |
|---|---|---|---|
| Monlam AI(第2.3.6.1节) | 面向学习、研究与创作的移动藏文语言服务 | 2026-10-20 | 1.0.0/2026-10-20[1] |
| Monlam Translate(第2.3.6.2节) | 藏英文本翻译、语音转文字及图像文字识别 | 2024-11-03 | 1.1.8/2026-10-19[2] |
| Monlam Keyboard(第2.3.6.3节) | 藏文输入、智能候选、自动纠错与实时修正 | 2024-10-25 | 0.3/2026-10-14[3] |
| Monlam Grand Dictionary(第2.3.6.4节) | 藏英查词、释义与音标信息、离线浏览和收藏 | 2025-11-03 | 2026.2.3/2026-10-20[4] |
| Tibetan-Chinese Dictionary(第2.3.6.5节) | 藏汉查询,超过50,000个检索条目,支持简繁体中文 | 2018-01-31 | 1.0/2018-01-31[5] |
| Chinese Tibetan Dictionary(第2.3.6.6节) | 汉藏查询,超过80,000个检索条目,支持简繁体与拼音 | 2016-09-05 | 2.1/2017-09-02[6] |
| Deutsch-Tibetisches Wörterbuch(第2.3.6.7节) | 超过15,000组德藏译对,连接印度技术团队与瑞士出版机构 | 2020-09-09 | 3.1/2025-01-16[7] |
表2-4 Lobsang Monlam名下10款移动应用(Apple美国区,截至2026年10月23日)(续)
移动端教育应用面向日常藏文使用。 Monlam AI由同名团队开发,商店将其列为教育应用,面向学习者、研究者、创作者及日常使用藏文的用户,并提供iPhone和iPad端入口。[4]
同名移动应用于2026年进入产品组合。 Apple美国区资料记载,该应用于2026年10月20日发布,版本为1.0.0,卖方为Lobsang Monlam。[4]
Android版将四类语言任务集成到同一应用。 Google Play介绍列有翻译、语音转文字、文字转语音和图像文字识别:用户可录音或上传音频生成可编辑转写,从文献页面、题记等图像提取藏文,再复制、分享或收听处理结果。应用支持藏英界面切换。[5]
机构与个人创作共用移动入口。 Android产品介绍进一步列出学生、研究者、译者、寺院和出版机构等用户。2026年10月24日,Google Play下载量显示为10+档位。图像转文字、转写和语音合成相结合,可帮助这些用户将纸本和口述材料整理为可分享的文字与音频。[5]
三类输入方式汇入藏英翻译。 Monlam Translate提供藏文与英文之间的文本翻译,同时支持语音转文字,以及从图像提取藏文的光学字符识别(OCR)。[1]
学习与交流构成主要使用场景。 商店介绍面向语言学习、文化阅读和日常沟通用户。该应用于2024年11月3日发布,1.1.8版本于2026年10月19日更新。[1]
Android版覆盖旅行、课堂和材料阅读。 Google Play列示的目标群体包括旅行者、学生、教育工作者和语言爱好者;使用示例包括拍摄路牌、菜单及文档,导入书页照片,以及进行藏英双语对话。2026年10月24日,该版本累计下载量处于10K+档位。拍照翻译可用于参访时理解文字说明、课堂中对照藏英表达;双语对话可辅助向英语使用者介绍藏文材料。[2]
语言辅助直接进入用户输入过程。 Monlam Keyboard提供藏文键入、智能文本建议、自动纠错和实时修正,适用于消息、文档及社交媒体文本输入。[3]
键盘扩展依托移动系统的输入机制。 Apple的自定义键盘开放访问由扩展配置请求,用户在系统设置中开启相应权限;安全文本输入使用系统键盘。该应用于2024年10月25日发布,0.3版本于2026年10月14日更新。[3][4]
词形与搭配预测有助于将藏文书写带入日常交流。 开发方进一步介绍了前后缀和词语搭配预测,针对藏文叠字逐字输入的操作提供辅助,场景包括短信、邮件及社交媒体表达。这种设计可减少藏文文本输入中的操作步骤,便于用户在手机上撰写文化讲解、活动通知和个人消息。[5]
词条查询同时呈现释义与音标。 Monlam Grand Dictionary支持藏文检索、藏英词汇查询、词条浏览和收藏,商店简介列有释义与音标信息,并突出离线使用。[6]
词库与个人查询记录主要保存在设备。 开发者政策将词典数据库、搜索历史、收藏及界面配置列为本地数据,并说明主动导出、配置同步、更新检查和语言包下载。该应用于2025年11月3日发布,2026.2.3版本于2026年10月20日更新。[1][2]
共同编纂的词典资源通过统一查询进入移动端。 开发方介绍,词典工程有37个以上编纂团队参与,2022年第三版印刷本为223卷;2025年软件第四版在藏文词典基础上汇入多部藏英、英藏词典,提供统一检索,便于读者并列查阅藏文释义与跨语种对应词。[3]
Android版以学习、翻译和研究为主要用途。 Google Play介绍明确列出学生、译者及研究者,并支持词语、短语和学术术语查询。2026年10月24日累计下载量显示为10K+。离线查询与词条收藏可支持课堂阅读、译稿处理和个人词汇积累。[4][1]
藏汉词条支持藏文阅读与学习。 Tibetan-Chinese Dictionary提供藏文至中文的词汇查询。开发者介绍列有超过50,000个检索条目,支持简体和繁体中文,面向学者、学生及藏文学习者。[5]
内容机构与技术团队共同开发词典。 应用由Monlam藏文信息技术研究中心与International Tibetan Buddhism Study Institute合作推出,后者为商店资料列示的研究合作方。Apple美国区所列首次发布日期和1.0版本更新日期均为2018年1月31日。[5]
已有词典的藏汉对照内容成为移动查询资源。 官方介绍将1991年出版的汉藏词典、藏英汉常用词资源,以及五语对照词典中的藏汉内容列为资料来源。中文释义与简繁体显示可帮助中文读者对照藏文词汇,为双语教学、文献阅读和文化概念解释提供查词入口。[6][5]
汉藏词条与拼音辅助汉语学习。 Chinese Tibetan Dictionary提供汉语至藏文的词汇查询,开发者介绍列有超过80,000个检索条目,支持简体、繁体中文及拼音。2.1版本说明还列有拼音修正和注音符号支持。[7]
同一合作关系覆盖两个查询方向。 该应用同样由Monlam ITRC与International Tibetan Buddhism Study Institute合作推出,服务汉语学习者及双语研究、教学使用。该应用于2016年9月5日发布,2.1版本于2017年9月2日更新。[1]
汉语书写与读音辅助连接藏文释义。 官方介绍将1991年出版的汉藏词典等资源纳入内容来源,并同时提供简体、繁体、拼音和注音符号。用户可从熟悉的汉语字形与读音进入藏文对应表达;在双语课程和交流材料准备中,这种查询方式可辅助统一常用词的表达。[2]
一万五千余组译对面向德语地区的日常交流。 Deutsch-Tibetisches Wörterbuch提供超过15,000组德语—藏语译对,词汇内容主要对应德语地区藏人社会的日常生活。[3]
出版机构与语言技术团队共同推出产品。 应用由Monlam ITRC(印度)与Tibet Institute Rikon(瑞士)联合开发,词表基于Losang Tenzin Mantö编写、Tibet Institute Rikon出版的德藏词典。该应用于2020年9月9日发布,3.1版本于2025年1月16日更新。[3]
三类学习者对应语言传承与跨语交流的不同需求。 Rikon的2020年报明确列出藏族年轻一代、新迁入德语地区的藏人,以及对藏语感兴趣的西方学习者。词条配有藏文发音转写,操作界面同时使用德语和藏语,可分别支持年轻用户学习母语、新迁入者学习德语,以及德语读者接触藏语词汇。[4]
免费移动和桌面版本延伸了词汇资源的使用场景。 产品覆盖iOS、Android、macOS和Windows四类系统。Rikon年报记录,截至2020年底,Apple与Google两家应用商店的全球安装量合计约3,000次;2026年10月24日,Google Play所列Android累计下载量为5K+档位。[4][5]
缩略条目以分层方式组织学习内容。 Monlam Elementary Dict的商店介绍列出220项英语缩略条目、370项入门条目及约1,290项基础文本条目,并说明采用简明释义。产品内容围绕藏文材料与西方缩略表达的比较展开。[6]
初学者和教师是其主要服务对象。 开发者将该应用定位为藏文入门学习及新教师的教学辅助工具。Apple美国区所列首次发布日期和1.3版本更新日期均为2023年2月20日。[1]
儿童学习设计将常用词、简短释义和图示结合。 官方介绍记载,应用于2023年在西藏基金会支持下面向初学藏文的儿童编制,按词语常用程度组织内容,提供拼读或连读方式,并为部分词条配图。图示与简明释义可帮助儿童把文字同具体事物联系起来,支持早期藏文词汇学习。[2]
基础教育用途同时延伸至Android设备。 Google Play将Monlam Elementary Dictionary定位为藏文初学者和小学使用的词典;2026年10月24日,其累计下载量处于10K+档位。[3]
专业术语解释服务佛典阅读。 Lamdre Tsigzoe Original围绕宗教、佛教及相关传统提供术语查询和详细释义,解释结合教义与文本语境。[4]
使用对象覆盖研究与专题学习。 商店介绍面向学者、相关实践者及希望理解经典、教义概念的读者。该应用于2024年12月12日发布,1.0版本于次日更新。[4]
专题词典把萨迦方面的编纂成果转为应用内容。 Monlam官方介绍记载,该产品于2024年由Monlam ITRC与萨迦方面的编纂团队共同制作发行,集中整理相关典籍和教义中的术语、解释。专业概念与其文本语境一同进入查询,可为专题阅读、教学和术语解释提供集中参考。[5]
Android版本补充了专业读者的访问渠道。 Google Play上的对应产品名为Lamdre Tsigzoe,2026年10月24日累计下载量为500+档位,定位于佛教研究者、相关实践者及经典阅读者。[6]
地点信息与音频内容构成文化导览。 Neykor围绕寺院、造像及文化活动组织内容,提供音频导览、地图位置和完整地址。[7]
文化学习与参访构成主要场景。 商店介绍面向计划访问文化地点或了解遗产的用户,以地点、历史与传统信息支持导览。该应用于2025年4月9日发布,1.4.1版本于2026年9月21日更新。[1]
文化机构管理与移动分发共同组织地点知识。 官方资料说明,Neykor由Monlam ITRC开发、由CTA宗教与文化部拥有并管理,网站设置寺院、节庆、造像和圣地四类入口。2026年10月24日,Google Play上的Android版本累计下载量为1K+档位。[2][3]
机构活动和社区旅游为导览内容提供传播场景。 2025年7月2日,Neykor在第十五次藏传佛教宗教会议上推出,该会议共有115名宗教及寺院代表等参加。西藏基金会2024年报将这款多语种应用纳入农村聚居区可持续旅游倡议。地点说明、音频和地图相结合,可将线上文化阅读衔接到实地参访,也为多语种访客了解聚居区寺院提供材料。[4][5]
Monlam门户与WB Academy提供查询和学习服务。 西藏基金会 2025 年报记载,Monlam 公共门户在 2025 年第四季度处理超过 130 万次请求,服务超过 2.5 万名用户。WeBuddhist 面向文本阅读、学习和社区活动;Sherab 学习平台组织课程、测验、论坛与学习进度,其对应 iOS 客户端现以 WB Academy 名称展示。[6][7]
WeBuddhist在持续活动中形成日常使用。 团队公布的2026年9月25日至10月15日活动报告按PostHog统计,应用21天累计用户3,484人,日均活跃用户984人,10月10日峰值为1,261人。同期有1,948人使用阅读器。[8]
英藏汉内容把跨语种阅读与远程参与连接起来。 该期“宗萨21天度母法会与教学”活动提供英语、藏语和汉语标题,活动界面语言分布分别为66%、17%和17%;1,528人进入直播,累计观看1,319.7小时。[1]
数字图书馆将语言技术接入馆藏管理。 藏人行政中央(Central Tibetan Administration,CTA)宗教与文化部组织数字图书馆项目,Wadhwani AI 与 Monlam ITRC 参与技术实施;藏文图书馆管理系统(Tibetan Library Management System,TLMS)连接目录、二维码、扫描及业务管理。项目首年公告记载,在 20 家机构开展培训,为 2,000 个书架和 70,000 部母本完成二维码集成;2026 年 3 月联盟会议报道列示参会机构49家。[2][3][4]
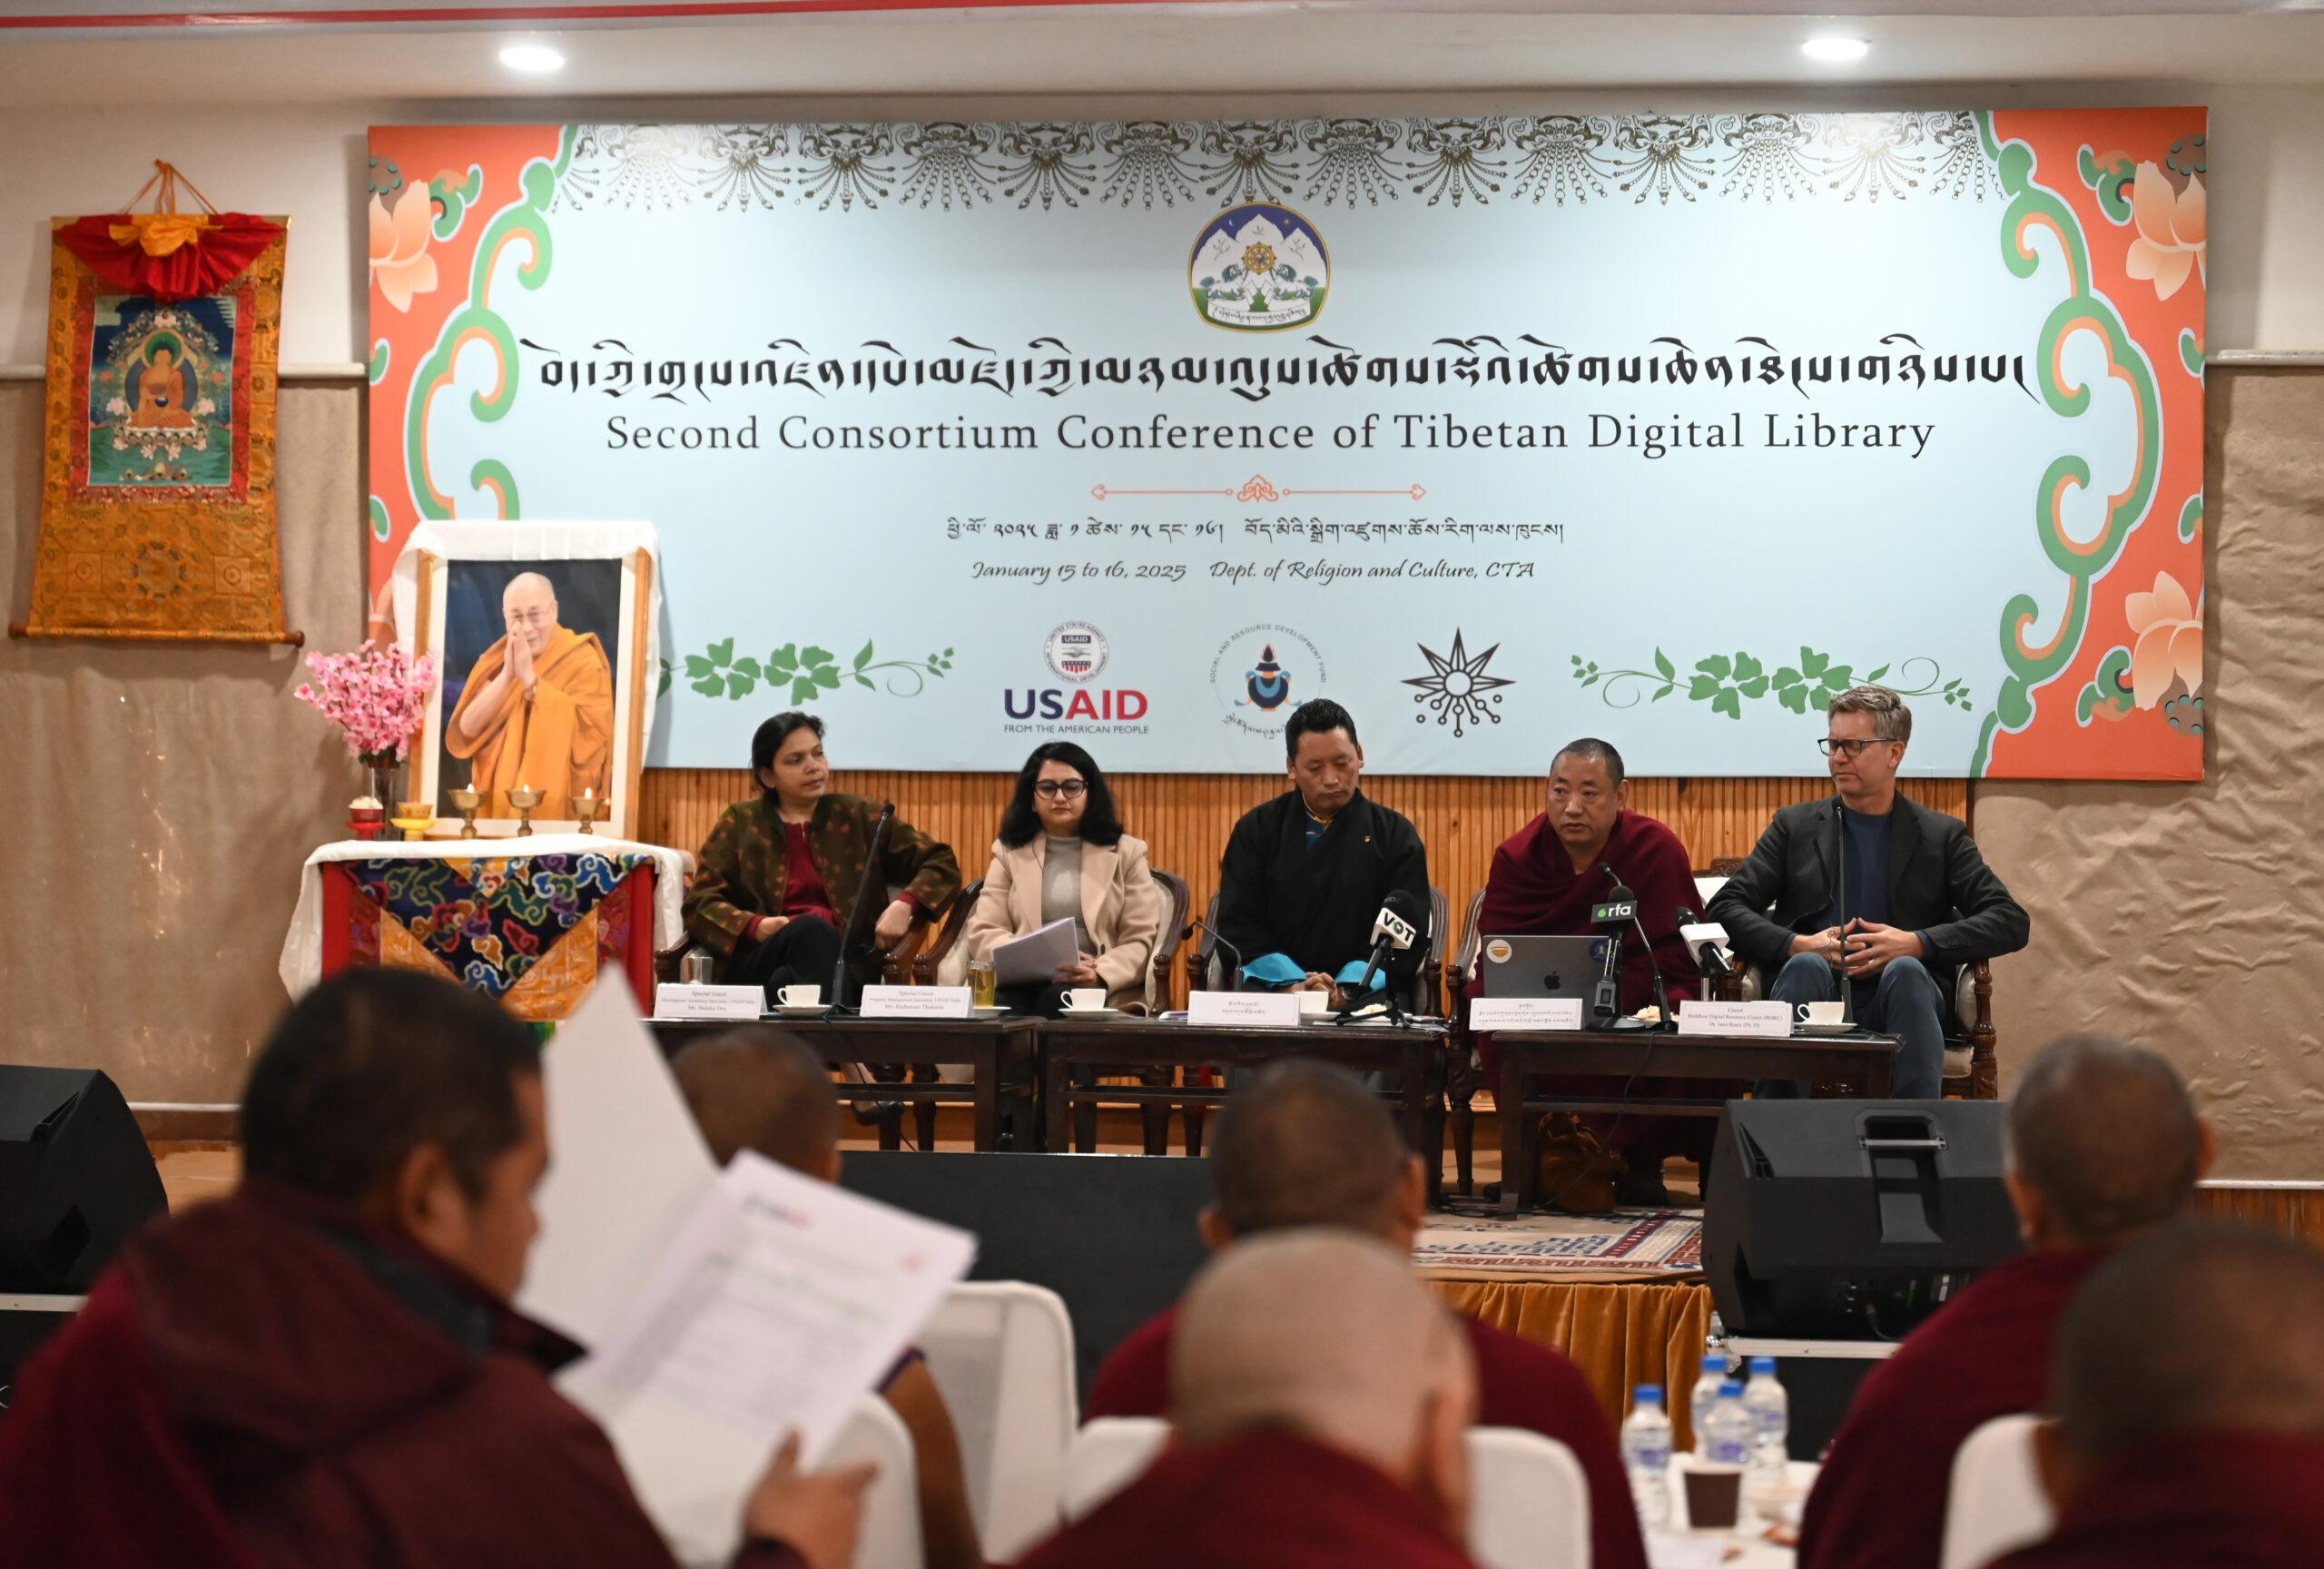
联盟会议把平台开发、文献加工与机构反馈放在同一议程中。 2025年1月15—16日,CTA宗教与文化部联合Wadhwani AI、Monlam ITRC举办第二届联盟会议,约58人参加;议程包括目录系统、数字图书馆原型及典籍数字化。[6]
活动后台将项目展示与技术培训组织起来。 Monlam 慈善信托(Monlam Charitable Trust)网站仓库设置项目、工作坊、媒体和管理等模块。工作坊记录分别介绍文本与图像标注、软件开发及版本协作等课程,达赖喇嘛高等教育学院(Dalai Lama Institute for Higher Education,DLIHE)的 2025 年 2 月院刊记载了软件工程实训合作。[1][2][3]
DeepZang以平行语料和方言语音支持产品服务。 西藏自治区经济和信息化厅2026年公开动态记载,DeepZang于3月15日发布,由西藏觉罗数字产业管理有限公司研发,完成深度合成服务算法备案与生成式人工智能服务备案;所列规模为近7,000万条藏语平行语料和超过30,500小时三大方言语音。[4]
语料与训练研究正按完整开发流程组织。 电子科技大学、西藏大学等团队的藏文基础数据集(Tibetan Foundation Dataset,TFD)论文在 2026 年 5 月版本中,统一介绍 TIBSTC、TIBSTC-CoT 和 Sun-Shine 模型系列,覆盖预训练、指令、安全、偏好和推理数据。天津大学团队在 ACL 2026 发表的研究则围绕 72 GB 藏文语料,以 Qwen2.5-7B 开展多语持续预训练,并扩展至混合专家模型。[1][2]
TFD论文的预训练Corpus子集列有122,756,184条实例、11B词元(约110亿)及18GB数据。[1]
表2-5 国内主要产品与研究资源的量化记录
| 产品或研究 | 来源所列规模或技术路线 | 资料与应用形式 |
|---|---|---|
| DeepZang | 近7,000万条平行语料、超过30,500小时语音 | 研发发布、交互与翻译产品、备案记录[3] |
| 阳光清言V1.0 | 约288亿词元训练语料,千亿参数级 | 2026年6月公测上线报道[4] |
| TFD/Sun-Shine | TIBSTC综合资源超过110亿词元,预训练Corpus子集约110亿词元;配套指令、安全、偏好数据,TFD另含TIBSTC-CoT推理数据 | 论文与项目介绍[1] |
| 天津大学藏文持续预训练研究 | 72 GB语料,Qwen2.5-7B基座,扩展50B-A10B混合专家模型(约500亿总参数、100亿激活参数) | ACL 2026论文[2] |
| FTibSuite | 数据FTibData、评测FTibBench、基于Qwen3-VL-8B-Instruct的FTibVLM | 三阶段视觉语言适配研究[5] |
表2-5 国内主要产品与研究资源的量化记录(续)
| 产品或研究 | 来源所列规模或技术路线 | 资料与应用形式 |
|---|---|---|
| Ti-Audio | 多方言端到端语音语言模型,动态Q-Former适配 | 语音识别、翻译及语音任务研究[1] |
| MiLiC-Eval | 论文约2.4万条实例、9项任务,覆盖4种语言 | ACL 2025 Findings论文、数据与评测程序[2] |
| 少数民族语言标题生成(Chinese Minority Headline Generation,CMHG) | 藏文100,000条、维吾尔文和蒙古文各50,000条 | EMNLP 2025论文及公开数据入口[3] |
| 布达拉宫古籍保护利用 | 3.6万叶数字化采集与识别,累计投入1.104亿元人民币 | 2026年6月项目进展[4] |
| CMiLBench/TLUE | 前者三语言合计24,663条、17项任务;后者理解5领域67子领域、安全7子领域 | ACL 2026、EMNLP 2025论文及项目入口[5][6] |
公开资源提供了多任务研究与应用入口。 MiLiC-Eval项目同时发布代码、数据划分和评价脚本,研究涵盖四种语言、九类任务。[1]
标题生成数据形成了专题训练资源。 CMHG论文提供藏文100,000条、维吾尔文和蒙古文各50,000条标题生成样本。[2]
资源、工具、模型和终端共同构成实际供给。资产规模体现可投入的材料,训练采用体现技术作用,用户和机构记录体现服务使用;维护这些成果还需要持续的人员、存储、计算和现场支持。
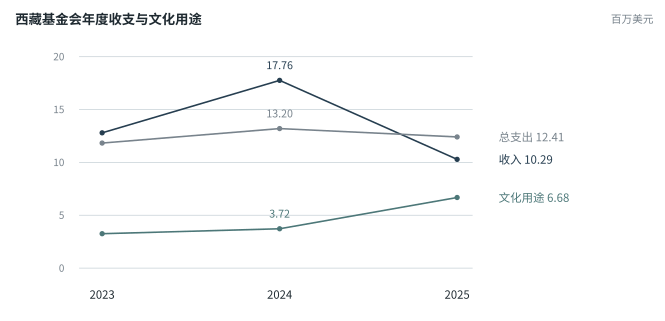
资金沿两条线索进入技术生态:政府协议按项目和执行节点追加,再通过次级资助进入执行机构;基金会、私人支持与经营收入共同承担研发和日常成本。机构财务呈现2024年收入上升、2025年回落而文化用途支出持续增加的变化。
SARD的项目筹资能力在直接资助建立前已持续扩大。 2019—2020年报记载,机构年度项目获资额由2016年的290万美元增至2020年的1,250万美元,员工与顾问由19人增至39人;储备资金由1,270万印度卢比增至3.7亿印度卢比。[1]
2020年直接资助将语言内容与机构能力建设纳入同一项目。 2020年6月23日,USAID向SARD授予997,124美元,由当时的主任Kaydor Aukatsang代表SARD/CTA签署两年期Tibetan Resilience Project合作安排。教育部承担藏语振兴部分,涉及动画、有声书、六至十二年级儿童读物、学习门户及青年语言文化活动;SARD负责Gangjong Development Finance的业务规划、管理信息系统和培训。[2]
较早项目的结项资料延续到2023年。 USAID监察长办公室2024年6月备忘录列明,SARD所管理的Tibetan Resilience Project协议为72038620CA00008,结项审计期间覆盖2022年4月1日至2023年4月22日;同一备忘录还列有AID-386-G-16-00001项下次级资助,以及22-21112A-TIB.0-2251能力建设项目。[3]
2023年两项文化项目的计划规模合计750万美元。 2025年3月公开资助清单列SARD协议72038623CA00005的项目总额为2,500,000美元,Wadhwani协议72038623CA00006为5,000,000美元。技术项目的2023年招标文件将500万美元分为三年基础阶段300万美元和两年后续阶段200万美元,任务围绕文献保存、数字平台访问及管理能力建设,并明确要求实施方与SARD协作。两项累计支付义务合计为3,039,514美元。[1][2][3][4]
协议执行通过后续增加支付义务扩大资金安排。 2023 年签署的两项协议首次义务额分别为 750,000 美元、1,689,514 美元,2024 年 8 月分别增加 400,000 美元、200,000 美元。西藏基金会协议于 2024 年 9 月首次形成 5,978,000 美元义务,2026 年 3 月增加 2,698,086 美元。截至2026年10月23日,该协议的已报告支出为 6,835,150.71 美元。[5][6]
五年期计划为经济、社会和文化项目提供持续安排。 西藏基金会 2025 年审计附注列示,“南亚藏人社区自立与韧性计划”(Program for Self-Reliance and Resilience of Tibetan Communities in South Asia)对应协议 72038624CA00006,计划期为 2024—2029 年,计划资助额 30,000,000 美元;截至 2025 年末,累计会计确认收入为 2,585,831 美元,可用资助余额为 27,414,169 美元。[7]
表2-8 西藏基金会2023—2025年收支、文化项目与年末财务状况(单位:美元;审计报表)(续)
| 指标 | 2023年 | 2024年 | 2025年 |
|---|---|---|---|
| 其中:捐款收入 | 2,584,113[1] | 7,245,542 | 4,961,661[2] |
| 总支出(活动表列示费用) | 11,828,030[1] | 13,197,165 | 12,406,742[2] |
| 文化和宗教保护/文化遗产保护支出 | 3,255,698[1] | 3,722,492 | 6,679,975[3] |
| 按费用性质列赠款及捐助支出 | 10,164,418[1] | 11,333,204 | 10,688,076[3] |
| 年末现金及现金等价物 | 774,359[1] | 5,665,422 | 1,818,185[4] |
| 年末总资产 | 9,682,601[1] | 14,429,768 | 12,284,575[2] |
| 年末净资产 | 8,460,085[1] | 13,019,562 | 10,899,053[2] |
现金积累集中在2024年,2025年出现较大消耗。 年末现金从2023年的774,359美元升至2024年的5,665,422美元;2024年余额中5,000,000美元为受捐赠用途限制的现金。2025年现金降至1,818,185美元,下降67.91%,净资产减少2,120,509美元。2024年、2025年末现金占相应年度支出的比例分别为42.93%、14.65%;2025年末一年内可用于一般支出的金融资产为8,771,978美元,包含现金、投资和应收款等。[1][2][3][4]
私人支持承担了数字图书馆项目资金短缺期间的人员成本。 藏人行政中央(Central Tibetan Administration,CTA)2026 年 3 月第三届藏文数字图书馆联盟会议报道回顾,上一年度资金短缺期间,意大利资助者 Alessia Bulgari 提供了项目员工一年的工资支持。[1]
私人资助者的文化与公益经历延伸至项目人员支持。 Alessia Bulgari曾参与《小活佛》的剧照摄影;2017年出版资料介绍,她是2008年成立的Pianoterra的联合创办人和主席,摄影集《Little Ones》的收益用于该机构。Emory University的Compassion Shift项目也将其列为捐赠人。2026年数字图书馆会议所记的一年工资支持,把这一私人公益资金来源连接到馆藏项目的日常运营。[2][1]
美国2026财年拨款设置文化、社区和行政能力用途。 美国于 2026 年 2 月 3 日签署的 Public Law 119-75《2026 年综合拨款法》第 7043(k) 条,列明至少 10,000,000 美元用于中国境内藏人社区的文化传统保护、可持续发展、教育和环境保护;至少 8,000,000 美元用于难民及离散藏人社区文化语言保护、发展和韧性等项目;至少 5,000,000 美元用于 CTA 能力建设,其中最高 1,500,000 美元安排于相关经济增长和能力建设用途。三类最低拨款合计 23,000,000 美元。[3]
专业工具由资金、人员和数据整理共同建设。 藏文批处理工具 pybo 的项目说明列明,钦哲基金会(Khyentse Foundation)提供 22,000 美元启动资助,佛教数字资源中心(Buddhist Digital Resource Center,BDRC)提供两名人员参与六个月数据整理,Barom/Esukhia 典籍项目支持训练数据整理。[4]
基金会投入覆盖翻译和文本保存等上游环节。 钦哲基金会 2025 年报财务摘要的统计期间为 2024 年 7 月 1 日至 2025 年 6 月 30 日,其中翻译支出为 1,508,874 美元,文本保存支出为 471,828 美元。受助项目分类在文本保存项下列 BDRC,在翻译项下列 Esukhia Canada。[1][2]
BDRC审计报告列示机构年度收支及资产。 BDRC 的 2024 年审计报告列示,全年收入及支持总额为 2,195,554 美元,支出为 2,147,535 美元,年末总资产为 3,783,976 美元。[3]
新的数据资助把文献加工与人工智能开发连接起来。 BDRC 于 2026 年 2 月公告,钦哲基金会支持的开放佛教数据集计划自 2025 年 12 月开始,安排延续至 2027 年夏,目标是加工数百万页文献、形成数万份标准化电子文本,并面向人工智能开发者发布。[4]
人员协作使语料整理和模型开发获得持续的专业支持。 西藏基金会 2023 年报记录,Monlam 相关项目有来自印度高校和寺院的 320 余名藏人参与兼职工作,并得到谷歌、加州大学伯克利分校和汉堡大学专家协作。[5]
Dharmamitra将基金会合作、学术项目资金与计算资源汇聚到研发任务。 Tsadra Foundation与Dharmamitra开展三年佛典翻译和研究工具合作;2025年Schmidt Sciences的HAVI项目把Nehrdich所在团队与哈佛大学Peter Bol牵头的欧亚文本检索研究连接起来。2026年6月22日,Dharmamitra公告获日本文部科学省AI for Science(SPReAD)500万日元支持,用于《国译一切经》等文献及佛典知识图谱,并获得大阪大学SQUID高性能计算集群优先使用安排。[6][7]
技术与数据服务被纳入社区投入和持续经营安排。 Dharmaduta 的经营说明提出,将相关服务利润的 70% 用于社区发展、30% 用于可持续经营,并将创作者活动纳入支持范围。[8]
公开捐赠咨询连接社区支持与基础设施维护。 OpenPecha 官网设置 25、50、100、250、500、1,000 美元及其他金额的捐赠意向选项,通过咨询表接收支持意向,列明社区赠款和基础设施维护等用途。[1]
社区资助把技术人员的组织能力转为开放内容。 Tenzin Kaldan组织的藏文维基编辑与校对项目获支持432,000印度卢比。项目方2026年5月提交的成果报告列报支391,925印度卢比,活动期为2025年11月至2026年4月,覆盖7个场地、300名参与者和9名组织者;藏文Wikipedia新增546页、改进668页,Wikisource新增546页、改进680页。[1][2]
数字图书馆项目将行政组织、受款安排和技术实施连接起来。 CTA 宗教与文化部负责机构协调,SARD 与 Wadhwani 人工智能基金会分别持有 2023 年合作协议,Wadhwani AI 承担主要技术工作,Monlam ITRC 参与数字资源库开发、培训和分类框架建设。首年公告记录培训和二维码编目,2026年联盟会议记录49家项目参与机构参会。[3][4][5][6][7]
基金会的项目管理程序将拨付与进展报告相衔接。 西藏基金会 2023 年税务申报补充说明列有管理层审查受助方及项目、董事会批准年度预算、准备书面赠款协议、签署后拨付,以及季度财务和项目报告等环节;美国政府资助项目另有现场访问和年度合规审计安排。[8]
项目资金、机构收支和专业投入各自承担不同作用。协议追加支持阶段建设,文化支出及次级资助继续流向执行机构,工资与技术岗位维持日常更新;资金变化由此能够传到数据生产和产品维护。
风险沿内容生成、数据处理和服务运行三条路径传递。模型与传播环节影响用户接触的材料和结论,资源加工及分发影响数据控制,格式、云服务、关键岗位和资助则共同影响可替换性与持续性。
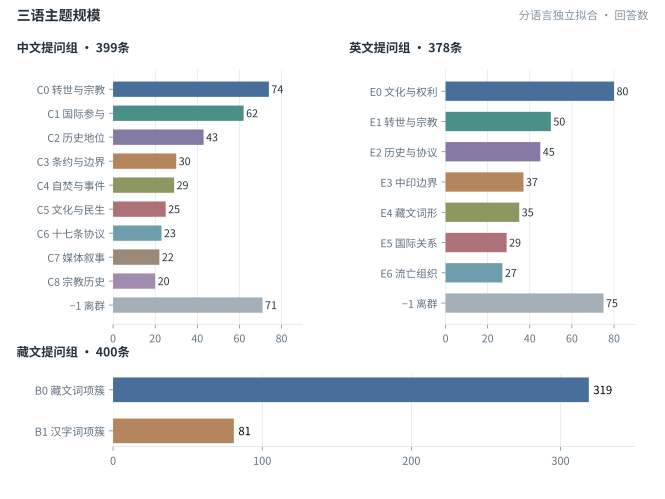
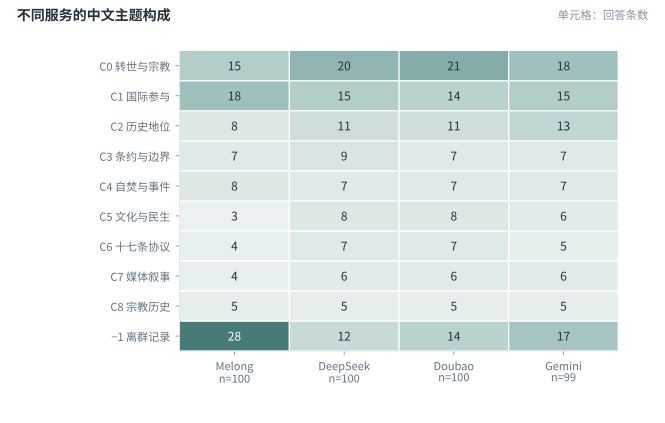
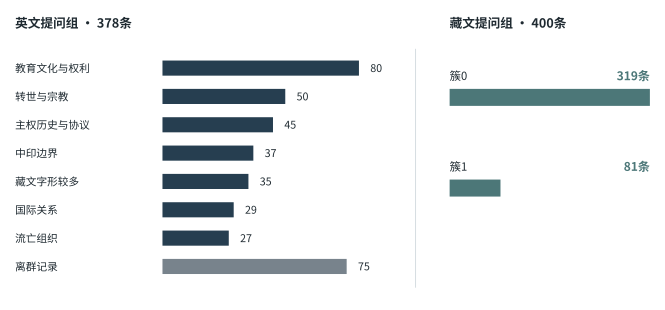
主题分布呈现回答围绕哪些议题展开,书写系统和引文则影响内容阅读与追溯。BERTopic分析形成中文9个、英文7个和藏文2个主题簇;中文组规模最大的三类主题共179条,占399条拟合回答的44.86%。同题史料选择、题干扩展和引用占位进一步呈现具体的内容判断问题。[1][2][3]
题库以同题三语方式覆盖五类政治历史议题。 100道题分为主权与历史地位、社会事件与流亡政治、活佛转世与宗教政治、人权教育与文化政策、边界与外部介入五类,每类20题,分别以中文、英文和藏文向Monlam Melong、DeepSeek、Doubao及Gemini提问,共形成1,200条问答评测。[4]
表3-1 四组模型的评测规模与答复构成(续)
英文和藏文组的聚类还呈现出输出文字的影响。 英文组378条回答形成7个主题簇和75条离群记录,其中35条构成以藏文词形为主要代表词的主题,均来自Monlam Melong。藏文提问组400条形成319条和81条两簇,81条簇全部来自Doubao;相应的书写系统分布见第3.1.4节。[1][2]
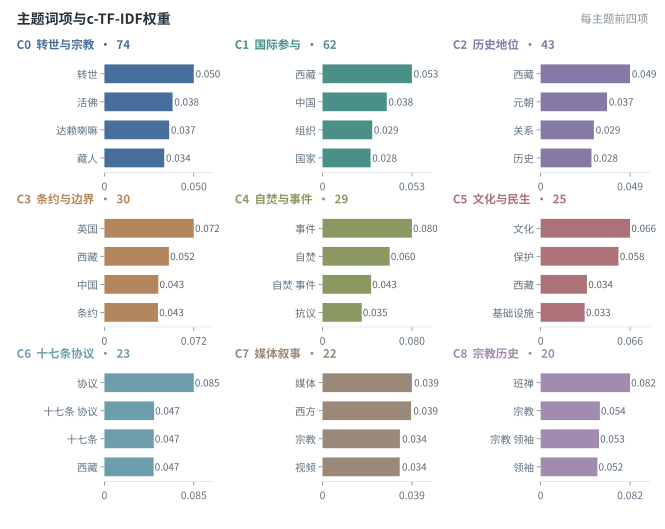
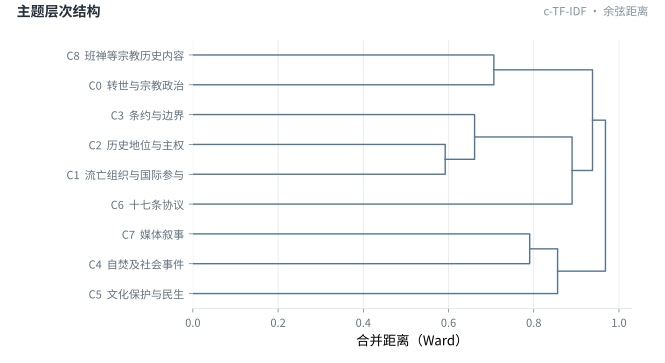
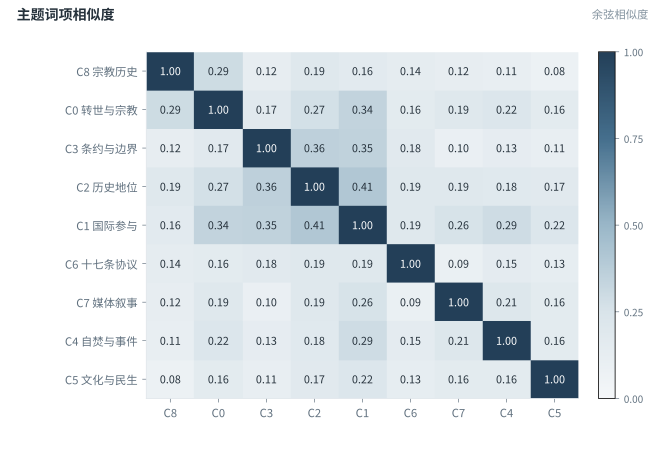
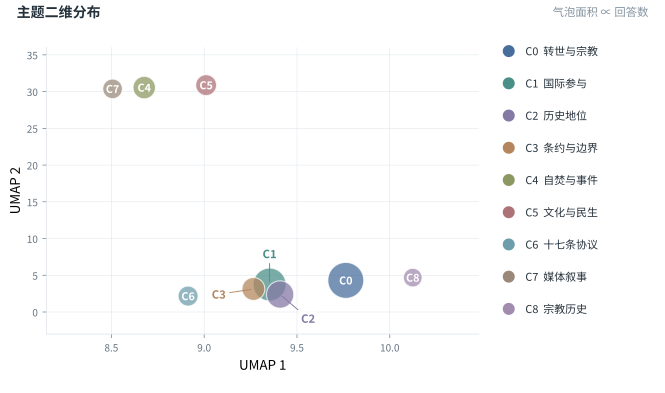
主题规模与二维位置共同呈现词项结构。 主题图以完整c-TF-IDF向量为基础,经UMAP投影展示9个中文主题。转世宗教、国际参与和历史地位的气泡较大,社会事件、文化民生和媒体叙事在图中形成另一组相邻位置。[3]
Doubao的藏文提问样本呈现连续的汉字占优输出。 POL-20至POL-100共81条记录的藏文区段字符为0,POL-01至POL-19则为藏文区段字符占优。主题聚类中的81条分组与这一书写系统分布对应。[1]
围绕历史国家地位的同题记录呈现出不同的论述方式。 POL-02 的中文答复中,Monlam Melong 从特定历史文献出发给出独立国家判断,DeepSeek 与 Doubao 以元代以来的中央管辖叙述展开,Gemini 则以历史时期及“主权国家”的定义作为回答起点。[3]
表3-3 POL-02中文原答摘录及叙述起点
Melong对同一历史题的中英答复使用相近结论。 中文答复以《我的国家、我的人民》等书名组织论据,并在结尾重申相应历史判断;英文回答开头为“According to the sources, Tibet was formerly an independent country.”,随后从宣告、外交关系及国际承认等方面展开。[4]
同一篇回答同时包含历史引述与概念区分。 POL-73关于外国政府会见达赖喇嘛的中文回答中,Monlam Melong罗列多国外交表述,结尾分别讨论象征性支持、正式承认及各国外交决策。[5]
题干中的文书名称被扩展为条款和历史判断。 POL-06 的题干带有“1913年的《西藏—英国条约》”这一名称。Monlam Melong 的中文回答沿用该名称,进一步介绍贸易、邮政和领事合作,并写道:“该条约的签订表明,当时国际社会普遍承认西藏是一个独立的国家”。[1]
英国外交部历史部门编纂的1920年《Tibet》手册记载,西姆拉谈判始于1913年10月13日,草案于1914年4月27日草签。[2]
Melong有23条答复出现76次引用占位标识。 这23条占292条成功答复的7.88%,其中中文3条、英文2条、藏文18条。POL-10中文回答以五个分点说明1950年相关事件,其中四个分点出现“[None]”。[3][4]
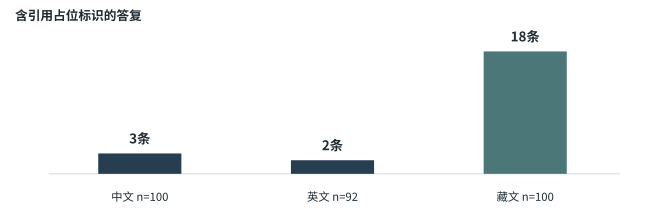
同题回答差异、文书前提扩展和引文占位共同影响用户判断,输出文字偏离又影响跨语使用。回答质量取决于资料选择、推理组织、引文定位和语言适配的衔接;当这些回答进入查询和课程,影响会进一步沿产品渠道传播。
内容影响经过三个环节扩大:词典和语料决定可选材料,检索、问答和输入工具决定呈现方式,应用、
课程与机构培训形成反复使用。技术成果进入听证和公开活动后,产品能力又成为政治文化主张的展示材料。
数据与工具分别进入训练。 佛教数字资源中心(Buddhist Digital Resource Center,BDRC)的 Yigdzin 1 藏文文字识别模型在训练配方中列有 ALL-BDRC 图文对齐资源和 BoCorpus 合成页面;PaganTibet 的文本规范化项目采用定制 Botok 版本准备 KenLM 语言模型训练数据。[1][2][3][4]
检索增强生成将资料检索与回答组织连接起来。 检索增强生成(Retrieval-Augmented Generation,RAG)先获取相关资料,再将其用于回答。buddhist-consensus 项目的现有说明以 Webuddhist AI 为名,支持关键词、语义、混合和精确匹配四种检索,提供题名及语言筛选、父子文档检索,并通过流式事件返回检索结果。[1][2][3]
检索工作流将文献片段转为生成上下文。 buddhist-consensus的检索工具返回文献标识、标题和文本,工作流对检索消息进行相关性评分,再用于回答生成。知识集合、查询条件、段落排序和提示配置共同参与答案形成。[2]
上下文上限使资料排序成为内容选择环节。 WeBuddhist的分段问答从OpenPecha Library读取关联资料。项目配置文档列示:默认最多选取80个关联片段,单片段上限8,000字符,关联资料文本合计上限60,000字符;程序先按来源类型排序,同类保持接口返回顺序,再依次装入上下文。资料较多时,排序及截取会改变实际进入生成模型的文献范围。[5]
题目、参考答案和领域分布共同确定评测所关注的能力。 MonlamAI 发布的 Bo-Eval 包括 BoBench 和 Bo-voice。BoBench 以 6,123 道单项选择题组织藏文语法、文学和历史知识,数据卡提供题目、选项、参考答案及专家信息;Bo-voice 以 8,367 组音频与转写覆盖儿童语音、有声书、历史、电影、自然语音、新闻、播客和教学等场景。[1][2][3]
创作者活动将线下交流延伸为线上课程。 2026 年 1 月 29 日至 2 月 6 日,佛教创作者大会在菩提伽耶举行,国际佛教联合会(International Buddhist Confederation,IBC)活动记录列有 120 名内容创作者注册,议程涉及数字内容、品牌策略和人工智能。Sherab 的 Buddhist Creators 页面将大会中的 WeBuddhist Influencer Masterclass 转为线上课程,提供标准版及 Triratna Edition 两个入口。[1][2]
表3-4 主要产品与传播场景的量化记录(续)
词典和人工智能成果被用于涉藏议题的公开陈述。 2024 年 12 月 5 日,Monlam 创办人格西洛桑门朗(Geshe Lobsang Monlam)参加美国国会及行政当局中国委员会(Congressional-Executive Commission on China,CECC)听证,在书面陈述中讨论词典、人工智能及语言文化保存。同月 12 日,美国国会图书馆举行 223 卷大词典介绍活动。2025 年 10 月 25 日,ICT 在柏林举行颁奖活动,主办方记录有 150 余名嘉宾,颁奖词提及词典和人工智能工作,同场发言涉及涉藏政治主张。[1][2][3][4]
听证问答明确联系技术项目与叙事表达。 在2024年12月的CECC听证中,委员Zach Nunn围绕涉藏叙事与人工智能提问,洛桑门朗介绍以现代技术回应中国政府相关叙事的工作,自述大语言模型相关资源汇集逾50,000部藏文书,并谈及在线翻译与Dalai Lama AI计划。[5]
教育合作也连接技术人才培养和政治文化交流。 2025 年 9 月 3—7 日,西藏政策研究所(Tibet Policy Institute,TPI)、达赖喇嘛高等教育学院(Dalai Lama Institute for Higher Education,DLIHE)、藏学高等教育学院(College for Higher Tibetan Studies,Sarah College)及 Monlam 慈善信托共同举办 Tibet-Himalaya Relations Conference。报道记载约 30 名学生参加,会议讨论包含区域关系及相关政策主张。[6][7][8]
内容传播依托日常工具、学习活动和机构使用反复发生,词典释义、检索材料和评价答案各自参与内容形成。
机构合作扩展了文献数据的流转渠道。 2024年CTA项目团队赴美期间,与BDRC讨论数字资源转移并接受资源采集和保存培训,向美国国会图书馆、哥伦比亚大学介绍项目,并参访哈佛大学图书馆。Esukhia更早的数字化活动已连接84000与BDRC。[1][2][3][4][5]
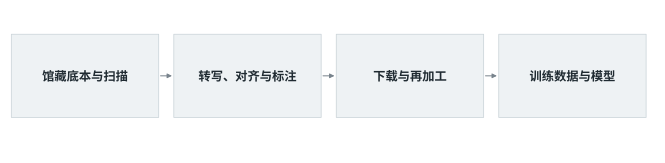
同一典籍在加工过程中形成多类数据对象。 馆藏底本经扫描、转写、校勘、目录编排和标注进入训练材料。原始文献、图像、电子文本和标注由不同参与方提供或加工。
表3-5 文献与语音加工形成的主要公开资产(续)
多方加工使数据发布与底本权利形成两层关系。 ALL-BDRC-alignments列明图像来自BDRC和ALL,ACIP转写由ALL提供,Dharmaduta承担对齐,钦哲基金会支持;数据卡标注CC0-1.0,并保留底本文献权利说明。底本、图像、转写和对齐结果分属不同加工环节,来源或使用条件变化时,更新会涉及发布方及已取得副本的下游使用者。[4][5]
集中存储改变了文本资产的访问方式。 OpenPecha Toolkit V2采用STAM,以位置关联正文与标注,并引入Firebase后端;工具同时支持导入、导出和转换。[6][7][8]
云端位置与导出功能由具体服务配置决定。 Firebase的Cloud Firestore提供区域或多区域位置选项,托管导出可将全部文档或指定集合组写入Cloud Storage,并涉及计费及访问权限配置。[8]
语音数据同时包含语言内容与声音特征。 stt-training-data采集概览记录截至2024年10月18日的1,391,020个音频文件、1,576.76小时和8类场景。声音特征可用于说话人匹配,录音与转写文本因而包含不同层面的个人关联信息。[1][2][3]
公开语音字段连接音频、转写及内容类别。 stt-training-data的8个字段为文件名、藏文转写、威利转写、音频地址、内容类别、数值字段grade、字符长度和音频时长。切片与转写以文件名和音频地址建立对应。[4]
公开分发使数据形成平台外副本。 Hugging Face支持下载指定版本的单个文件或完整仓库文件。平台发布、本地保存及下游再加工由不同参与者完成。[8]
BDRC开放数据计划扩大了文献的训练供给。 该计划自2025年12月开展,钦哲基金会的支持安排延续至2027年夏,目标是将数百万页文献加工为数万份标准化电子文本,向人工智能开发者使用的平台发布。[1]
模型训练采用不同图文资源。 BDRC 的 Yigdzin 1 文字识别模型在训练说明中列出 ALL-BDRC 图文对齐资源及 BoCorpus 合成页面,Bod_uchen_tesseract 列出五类典籍合集形成的行级图文对。[2][3]
训练材料变化涉及模型层面的更新。 NIST将机器遗忘定义为从已训练模型中选择性移除特定训练数据影响的技术。原始文件、训练数据与模型参数处于不同环节,数据调整进一步关联重新训练、机器遗忘或模型替换等技术路径。[4]
文件、索引与备份形成不同的保留层次。 原始文件、业务记录、搜索索引、向量条目、缓存、消息和备份分别保存数据或其派生内容。文献检索包含原文片段、索引和向量,异步服务还包含任务与队列状态。[1][2]
对象存储的历史版本与当前可见状态相互分离。 Amazon S3启用版本控制后,普通删除请求创建删除标记,旧文件继续作为历史版本保存;按版本标识删除和生命周期规则分别提供历史版本处理方式。[3]
账户与文件的退出由不同服务分别处理。 Monlam API通过数据库关系对翻译、文字识别、语音及聊天记录设置级联删除,文件对象、分析事件和备份分布于相应服务。大词典政策则将数据库、历史、收藏及界面配置列为本地保存,说明主动导出、同步及本机清理功能。跨产品使用中的资料退出因此涉及数据库、云服务与终端存储多个主体。[4][5][3][6]
底本与派生数据、业务记录与分析事件、当前文件与历史版本形成不同处理层次。资料控制需要把来源、用途、更新和退出连到各层对象及责任方,数据关系的完整保留也影响后续系统迁移。
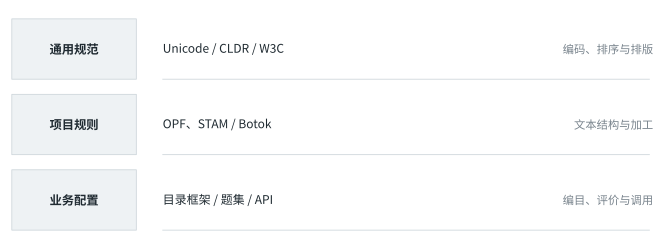
规则通过编码与排版、文本结构、语料处理、目录业务和模型评测五个环节影响结果。通用规范提供共同基础,项目工具和业务配置决定具体处理方式;正文、标注、标识与工作流程的关联又影响迁移成本。
Unicode提供藏文文本交换的共同编码基础。 Unicode18.0于2026年9月16日发布,其藏文区段U+0F00—U+0FFF包含256个码位,其中211个已分配。基本字母、下加字母及组合符号构成字符序列,规范化与字体整形分别参与文本处理和显示。[1][2]
W3C 的资源文档连接排版需求、测试和浏览器实现。 万维网联盟(World Wide Web Consortium,W3C)现行《藏文文字资源》(Tibetan Script Resources)为 2026 年 3 月 20 日工作组说明草案,由国际化工作组发布,编辑为 Richard Ishida,内容组织字体、分词选择、标点、断行、对齐和页码等议题,并连接相关测试及差距分析。2024 年 5 月 15 日版《藏文排版与印刷需求》致谢中,列有中文排版需求任务组及信标委中文信息处理分技术委员会、藏文信息处理工作组专家的贡献。[3][4]
藏文排序规则通过CLDR进入软件实现。 BDRC的Élie Roux于2021年介绍,相关规则于当年10月27日随CLDR发布,参与者包括Apple/CLDR委员会、BDRC和Esukhia。CLDR49藏文排序文件保留《藏汉大辞典》页码引用,排序数据影响名称、词条和题名的排列。[5][6][7][8]
格式将正文与标注关联起来。 OpenPecha 格式(OpenPecha Format,OPF)的说明以书目框架(Bibliographic Framework,BIBFRAME)2 模型组织元数据,注释设计参考文本编码倡议(Text Encoding Initiative,TEI)。Work 表示作品,Pecha 对应具体数字版本,Item 记录数字副本;base 保存正文,layers 保存分页等标注。[1][2]
分词规则通过大规模语料采用进入后续模型。 Botok 提供藏文词切分、词元、词性、规范化词形和自定义配置,pybo 提供批量分词、排序及替换等操作。PaganTibet 的 Tibetan-KenLM-ACTibtrainingdata 列有 17,731,410 行文本,项目采用定制 Botok 准备字符五元 KenLM 训练及候选重排序数据。[1][2][3]
词边界变化影响索引、对齐和训练材料。 人名、地名、异写、数字和混排文本的切分方式改变词频与文本单元;Botok的词表及参数进入语料加工后,其调整又影响下游检索、翻译对齐和模型输入。
转写与字体分别承担表示转换和字形显示。 pyewts支持藏文Unicode与扩展Wylie转写的双向转换,并提供转换警告;tibetan-fonts汇集多方字体,Monlam Font Viewer提供藏文预览和下载。[4][5][6]
词典编辑接口将释义变化带入下游产品。 MonlamGrandDictionaryEditor连接词条数据库、编辑账户及接口配置。词典版本和词条更新影响查词、编辑及采用该词表的语料处理。[7]
国内标准为排序、分词和文献标记提供共同规则。 国家标准全文公开系统列有《信息技术 藏文字符排序规范》(GB/T36335—2018)、《信息处理用藏文分词规范》(GB/T36452—2018)、《信息处理用藏文文献文本信息标记规范》(GB/T36338—2018)及《信息处理用藏语短语分类与标记规范》(GB/T36472—2018)。[1]
藏文输入布局同时进入国内标准和国际本地化数据。 《信息技术 虚拟键盘藏文字符布局》(GB/T46664—2025)于2026年5月1日实施,CLDR49同年新增古典藏文键盘。输入布局及组合方式连接键入、转写、排版和检索等后续处理。[2][3]
迁移涉及目录关系与既有工作流程。 更换软件会牵连目录字段、对象标识、二维码指向和文件关联;机构侧还涉及设备、权限、备份及工作人员的操作习惯。词典、翻译和学习应用则更多涉及查询、收藏、课程及学习记录。[4][6]
技术规则的作用由采用环节体现:编码影响交换,切分影响语料,标注位置影响转换,目录标识影响机构业务,题集影响优化方向。开放规范和可迁移接口能够减少转换成本,持续维护仍取决于服务与人员投入。
复用同一数据、工具和专业经验可以加快产品开发,也使多个产品同时受上游变化影响。数据偏差需要传到下游修订,服务调整需要应用适配,关键岗位和拨付变化需要运营接续,这些依赖共同决定生态持续性。
表3-9 跨项目依赖及其风险传导
表3-9 跨项目依赖及其风险传导(续)
共同输入可能使问题在不同下游重复出现。 图文识别使用扫描、转写和合成页面,文本模型使用切分后的语料,检索服务继续使用电子文本与标注。如果上游文本或加工规则出现偏差,同一版本的多个采用者可能受到共同影响;处理成本会从单份资源延伸到数据重处理、模型更新及应用内容调整。[1][2][3][4]
关键经历连接文献整理、数据架构和模型研发。 Ngawang Trinley参与Esukhia、84000、BDRC及Monlam/Mitra工作;Sebastian Nehrdich由BuddhaNexus开发进入MITRA技术与管理岗位,并于2025年加入日本东北大学;Élie Roux从BDRC数据架构延伸至开放数据计划。负责人和专家的知识横跨多个项目,岗位变动时,受到影响的可能同时包括资料生产、工具维护和研究合作。[1][2][3]
人员经费接续已经成为维持项目活动的实际需求。 西藏基金会2025年收入下降42.07%、支出下降5.99%,年末现金及现金等价物下降67.91%;数字图书馆联盟会议另记载,Alessia Bulgari在资金短缺期间承担项目员工一年的工资。对需要长期校对、更新和用户支持的技术项目,持续性取决于建设资助与后续运营经费的衔接。[1][2][3]
非现金投入同样构成维护依赖。 pybo的22,000美元启动资助与专业工时、训练数据整理共同形成工具,Dharmaduta则提出70%利润回投社区、30%用于持续经营。基金会、企业服务和专业协作分别承担不同成本,人员与资源支持的变化会影响可持续提供的服务范围。[4][5]
共同上游使局部变更产生跨项目影响,平台和经费条件又决定修订能否持续完成。内容、数据和运行问题因而需要连贯处理:既改善上游资源与规则,也保有服务替换能力和长期专业岗位。
应对技术生态影响,需要把内容可信、资源自主、接口兼容、数据责任和长期维护接续起来。建设重点是让资料能够追溯、工具能够替换、资源能够更新、专业岗位能够持续承担工作。
生态能力已从典籍资源扩展至模型、用户产品和机构业务。其影响通过知识选择与规则采用扩大,通过多平台数据处理和共同服务依赖传递,并由人员与经费维持;国内建设需要同时回应内容、资源、系统和长期运行问题。
人才把文本、架构与模型研究连到一起。 Ngawang Trinley参与典籍整理与模型协作,Sebastian Nehrdich连接互文检索与翻译研究,Élie Roux连接馆藏架构及开放数据。专业知识跨项目流动,也使维护工作与岗位配置相互关联。[4][5][6]
资金集中与年度变化影响运营接续。 三项合作协议累计联邦支付义务11,715,600美元,西藏基金会协议占74.06%。[7]
评测由100道涉藏问题、中文英文藏文三种提问语言和四组模型构成,总规模为1,200条。分析结合BERTopic主题建模与同题答复比较,观察主题分布、书写系统、历史叙述和引用质量。[1]
题库包含100道题及三种提问语言。 主权与历史地位、社会事件与流亡政治、活佛转世与宗教政治、人权教育与文化政策、边界与外部介入五类议题各20题,分别设置中文、英文和藏文提问。每条记录由服务标签、题号和提问语言联合标识。[2]
主题聚类依据原答的词汇特征。 BERTopic按提问语言分别拟合,采用词频加权、降维、密度聚类及簇代表词。主题分析涵盖1,177条答复,中文、英文和藏文提问组分别为399、378、400条。主题名称结合代表词与回答内容确定。[3][4]
问答记录日期和成功题目数随服务而异。 Monlam Melong问答记录日期为2026年8月12日,Gemini为8月11—12日;DeepSeek与Doubao沿用原始问答资料中的服务标签。三语均有成功答复的题目数,Melong为92道、Gemini为90道、DeepSeek与Doubao各为100道。[2][5]
书写系统按三类字符的占比划分。 计数对象为汉字、藏文Unicode区段字符(含该区段标点和数字)及拉丁字母。某一类占三类计数总和的至少60%,即记为该文字占优;其余为混合文字。[6]
中文提问组形成九个聚类,最大的转世与宗教政治簇含74条。 399 条拟合回答形成 9 个聚类及 71 条离群记录。规模较大的三个簇分别为转世与宗教政治 74 条、流亡组织与国际参与 62 条、历史地位与主权 43 条。关键词分别围绕“转世、活佛、宗教”“组织、国际、流亡政府”“元朝、历史、主权”等内容展开。[1]
表A-1 中文提问组的主题分布
英文提问组也受输出文字影响。 378 条回答形成 7 个聚类及 75 条离群记录。其中,教育文化与宗教权利簇为 80 条,转世宗教簇为 50 条,主权历史与协议簇为 45 条,中印边界簇为 37 条。另有一个 35 条的聚类由 Monlam Melong 回答构成,文本带有较多藏文字形。[1]
机构与人员资料对应具体项目职责。 机构介绍、登记资料、人员履历、合作公告和资助协议分别记录法定主体、技术角色、任职经历及受款关系。
代码与数据资料对应技术实现和公开规模。 项目代码说明接口与后台处理,数据卡和模型卡说明字段、规模、许可及训练材料,应用页面和产品政策说明用户功能与数据处理,机构公告记录培训和馆藏实施。
资金资料沿项目流向和年度收支组织。 合作协议与次级资助记录对应受款方、期限及累计支付义务;年报与审计资料对应机构收入、支出、现金和用途。现金资助、专业工时和数据支持共同构成技术项目投入。
企业、研究中心、非营利组织及信托分别出现在经营、项目合作、受款和治理资料中。
企业和非营利组织承接业务运营及区域拓展。 Dharmaduta Services LLP 的商业登记转录列明,有限责任合伙企业编号(LLP Identification Number,LLPIN)为 ACO-5775,成立于 2025 年 5 月 22 日,指定合伙人为 Yonten Wangchuk、Kalzang Furbu,出资义务为 100,000 印度卢比。Esukhia 的公开登记转录列有法国 RNA 编号 W332011667、加拿大公司号 15850983;其机构沿革介绍了 2024 年由加拿大非营利组织接续法国组织活动的安排。[1][2]
相关信托分别连接项目支持、办公室事务与行政治理。 达赖喇嘛信托(The Dalai Lama Trust)在 2022 年大词典发布记录中被列为支持方。达赖喇嘛慈善信托(H.H. the Dalai Lama’s Charitable Trust,HHDLCT)的 2026 年 2 月第 122 次受托人会议则列司政边巴次仁为主席、财政秘书 Tsering Dhondup 为管理受托人,并审议财报和预算。[2][3]
达赖喇嘛官网记载,甘丹颇章即其办公室,并于 2011 年以甘丹颇章信托(Gaden Phodrang Trust)形式在印度登记为私人信托,其公开职能包括宗教事务、教育和人道工作。CTA 的 2024 年机构介绍另记载,宗教与文化部于 1982 年以 H.H. the Dalai Lama’s Religious and Cultural Society 名称登记,2018 年依据喜马偕尔邦有关社团法律重新登记。[4][5]
外资管理将项目用途、地区和责任信息纳入组织治理。 印度《外国捐款监管法》(Foreign Contribution (Regulation) Act,FCRA)框架设有登记和事前许可等路径。印度新闻信息局 2026 年 7 月官方说明记载,既有机构按一年过渡安排补报活动用途及邦、地区信息。印度官方广播 2026 年 10 月 12 日报道,相关修法法案当时正由联合议会委员会听取利益相关方意见。[6]
外国捐款构成较大规模的机构资金来源。 印度《外国捐款监管法》(Foreign Contribution (Regulation) Act,FCRA)相关官方资料列示,2024—25年度约16,200家登记社团接收2,296.3亿卢比外国捐款。[7]
同一技术机构还参与教育方向的公益合作。 Google.org于2026年1月宣布向Wadhwani AI的印度自适应学习教育项目提供8.5亿卢比支持。[1]
收入差额对应两类明确的会计调整。 西藏基金会2023年审计报表的收入、收益及支持总额为12,794,979美元,Form 990列收入12,389,267美元,差额405,712美元。Schedule D列示的调整为投资未实现净收益381,409美元和租赁费用24,303美元。[2][3]
支出差额对应租赁费用的列报方式。 同年审计支出11,828,030美元,税务申报支出11,803,727美元,差额24,303美元,Schedule D补充说明将该项列为租赁费用。审计活动表同时提供文化和宗教保护、教育、健康及社区等用途分类,构成第2.4.2节年度趋势的资料基础。[3][2]
税务赠款分类合并了直接赠款、学生资助和贷款豁免。 2023年审计费用表列直接赠款及捐助10,164,418美元、学生资助732,024美元、贷款豁免30,000美元,三项合计10,926,442美元,与Form 990的赠款及类似支出对应。[2][3]
数字典籍浏览工具连接界面与数据服务。 Digital Kangyur提供数字典籍浏览与服务入口,公开项目说明采用React/Vite前端、Express/Prisma后端及PostgreSQL等组件。[4]
标注语料为古典文本分析提供具体研究材料。 莱希曼大学(Reichman University)与汉堡大学的古典藏文研究区分自撰与翻译性片段,提供标注语料及自动分段方法。[5]
研究综述组织资源、任务与模型之间的联系。 《Tibetan Language and AI》按资源、任务和模型梳理藏文人工智能研究。[6]